Claude による eval 設計とヒルクライミングの自動化
Automating eval design and hillclimbing with Claude
この記事は 原文 を DeepL で機械翻訳したものである。正確な内容は原文を参照のこと。
評価は、アプリやスキルが特定のタスクにおいてどのようなパフォーマンスを発揮しているかを示す指標となります。しかし、評価を設計し、自己満足に陥ることなくそのパフォーマンスを向上させることは困難です。そこで、claude-api スキルには、その両方に関するガイダンスを追加しました。
このスキルを使えば、 /claude-api build-eval を使用してコードベース内で評価を構築し、 /claude-api hillclimb これにより、過学習を防ぐために除外されたサンプルセットを用いて、変更を1つずつ加えながら、評価に基づいてアプリケーションを改善することができます。
この記事では、まず優れた評価関数の設計原則とヒルクライミング法について解説し、次にClaude Codeが claude-api skillを備えたが、それらの原則をどのように適用しているかを解説します。最後に、これらのコマンドの具体例をいくつか紹介します。
評価設計
適切に設計された評価には、いくつかの共通要素があります(図1):
- 評価課題は本番環境を反映したものであるべきです。「本番環境」、つまりテスト対象の機能やアプリケーションが実際に使用される環境において、重視すべき課題をサンプルとして取り上げてください。課題の選定にあたっては、作成が容易であることや採点が簡単であるといった理由で選ばれることもありますが、課題の構成が実際に重視すべき点を反映していることを確認することが重要です。
- モデルの性能が高まり、学習の度合いが増すにつれて、性能は向上します。通常、性能の高いモデルや学習の度合いが高いほど、評価テストでの成績は良くなるはずです。もしそうでない場合は、タスクが曖昧であるか、採点基準の調整が不適切であることが、性能の低下を招いていることが多いのです。
- フロンティアには「許容範囲内の」ヘッドルームがあります。最大の労力を費やして構築した最も高性能なモデルであっても、評価におけるスコアは100%を大幅に下回るべきです。そうでなければ、変更がパフォーマンスにどのような影響を与えるかを確実に判断することができません。 重要なのは、この差が「不可能な課題」や「曖昧な課題」によって生じているものであってはならないということです。よくある兆候として、反復回数の多寡にかかわらず、評価の実行ごとに課題が失敗してしまうケースが挙げられます。優れた課題とは、2人の分野の専門家が同じ結論に達し、採点者が確認すべき事項がすべて課題に明記されているものです。
- 実行間のばらつきが小さい。ばらつきが大きい場合、その原因は、設計が不十分で曖昧なタスクや、同一の出力に対して異なる判定を下す採点者にあることが多い。また、ばらつきは設定の中に潜んでいることもある。例えば、評価の厳格さが一貫して適用されていない可能性がある。 また、環境も評価結果に影響を与える可能性があります。以前の実験で残った状態(ファイルやGitの履歴など)が、エージェントに答えを教えている可能性があるからです。
敵対的サンプリング
モデルの性能にはばらつきがあります。今日のモデルが処理できないケースを選んで評価を行うと、あるモデルの性能曲面の「谷」の部分のみをサンプリングすることになります(図2)。その結果、その評価では、アプリケーションにとって本質的に困難であることや価値のあることではなく、そのモデルの「失敗のパターン」が測定されてしまう可能性があります。
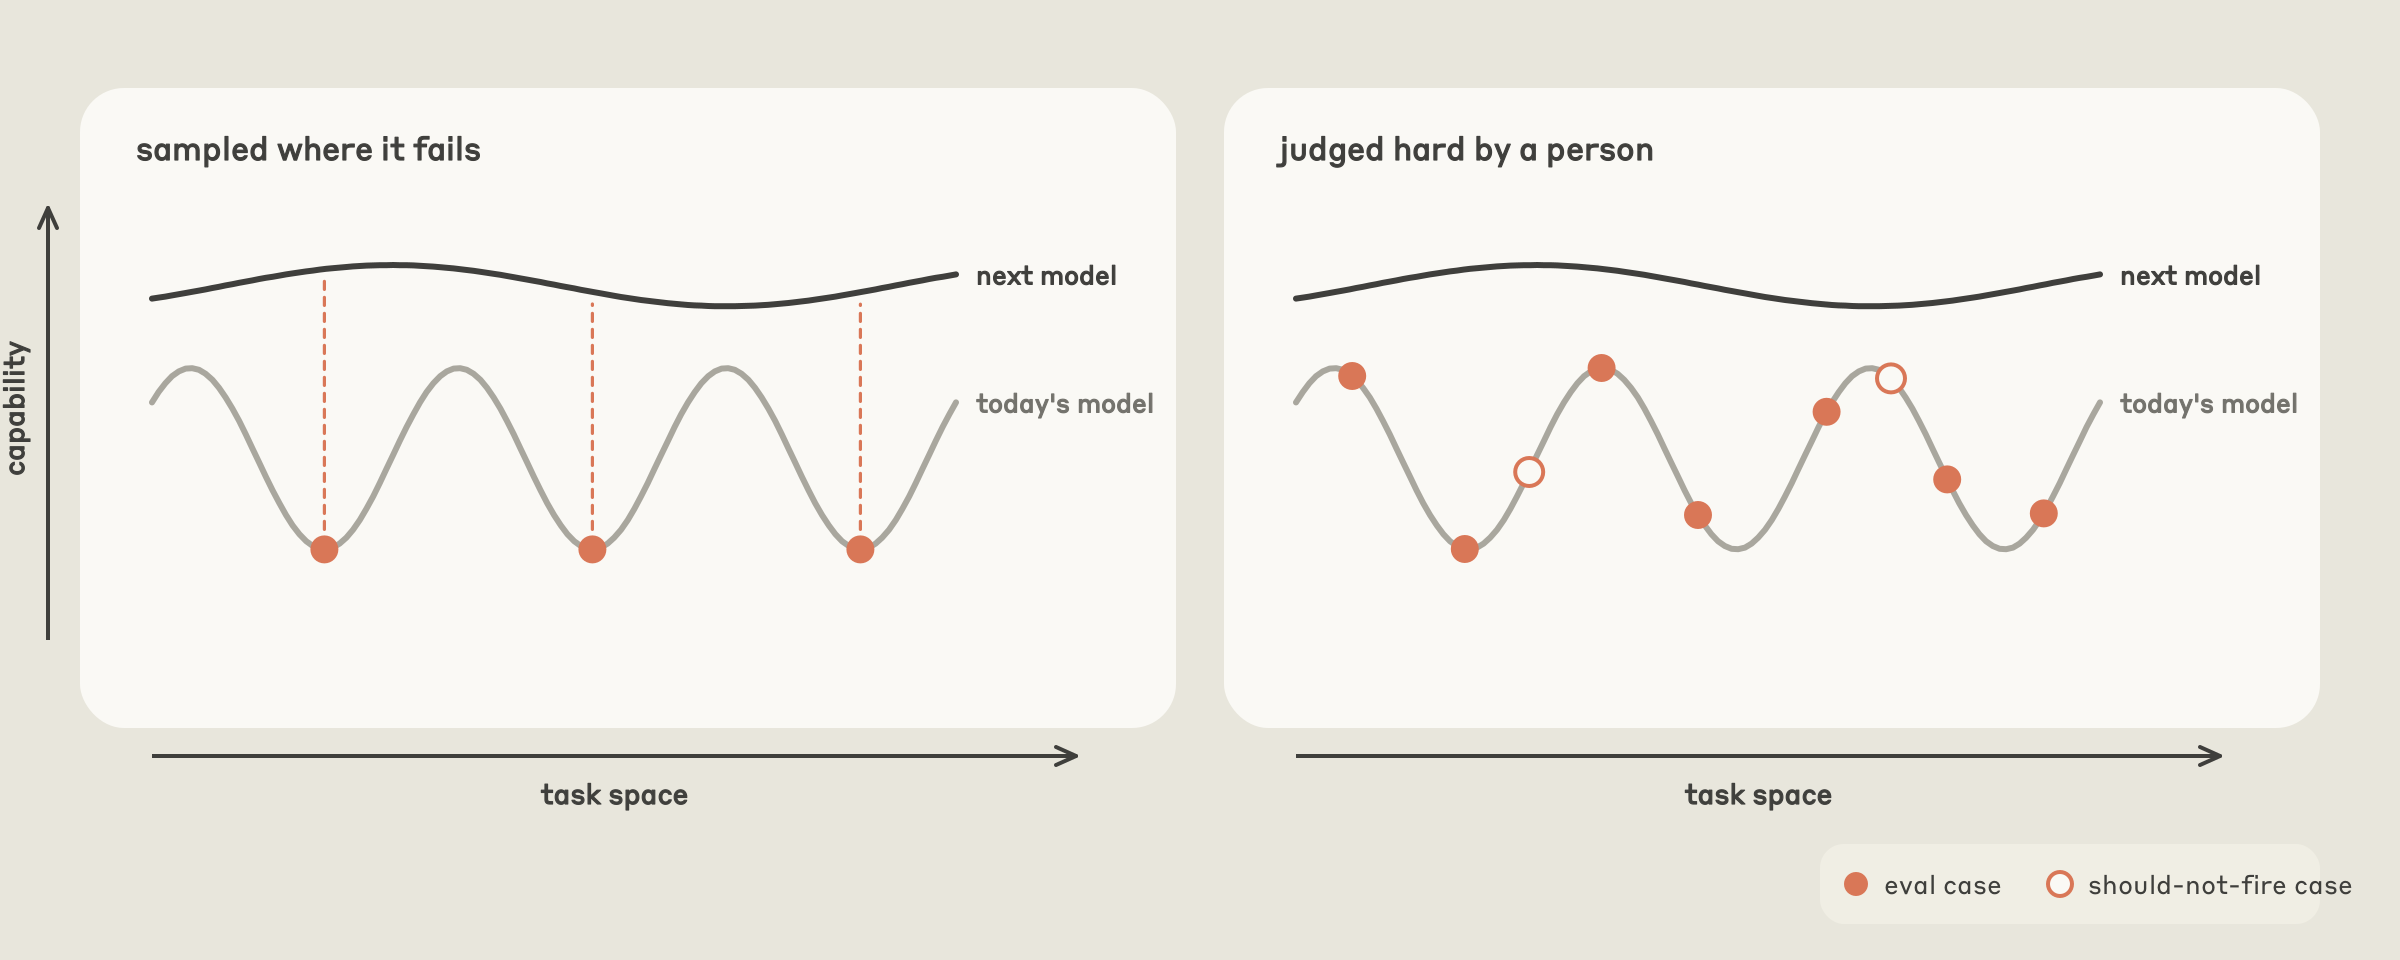
「難しい」と人間が判断したケースを選ぶこと。有用なテストとは、タスクを組み込む前に、なぜそれが難しいのかを説明できるものである。本番環境のトラフィック、バグ報告、またはチケットから得られた、アプリケーションにおける具体的な不具合のケースを含めること。 ただし、ユーザーのトラフィックを盲目的に信頼してはいけません。ユーザーは「うまくいくはず」と予想したことを試すことがあるため、ユーザーのトラフィックのみから導き出されたタスクの分布は、容易なタスクに偏ってしまう可能性があります。
/CLAUDE-API BUILD-EVAL
claude-api スキル内の build-eval claude-api スキル内のこのコマンドは、これらの原則をガイド付きのワークフローとして具現化します。 /claude-api build-eval Claude Codeでこのコマンドを実行すると、Claudeがユーザーに質問を行い、コードベース内にevalを構築し、特定のポイントで承認を求めるために一時停止します。
設計例
Claude この順序で評価を構築するために、入力のサンプリングを支援します:
- 保持期間や機密データについて確認した後の、制作用トランスクリプト。
- バグ報告およびサポートチケット。
- 5件から10件を手書きで記入してください。
- コードベースから生成されたテストケース。
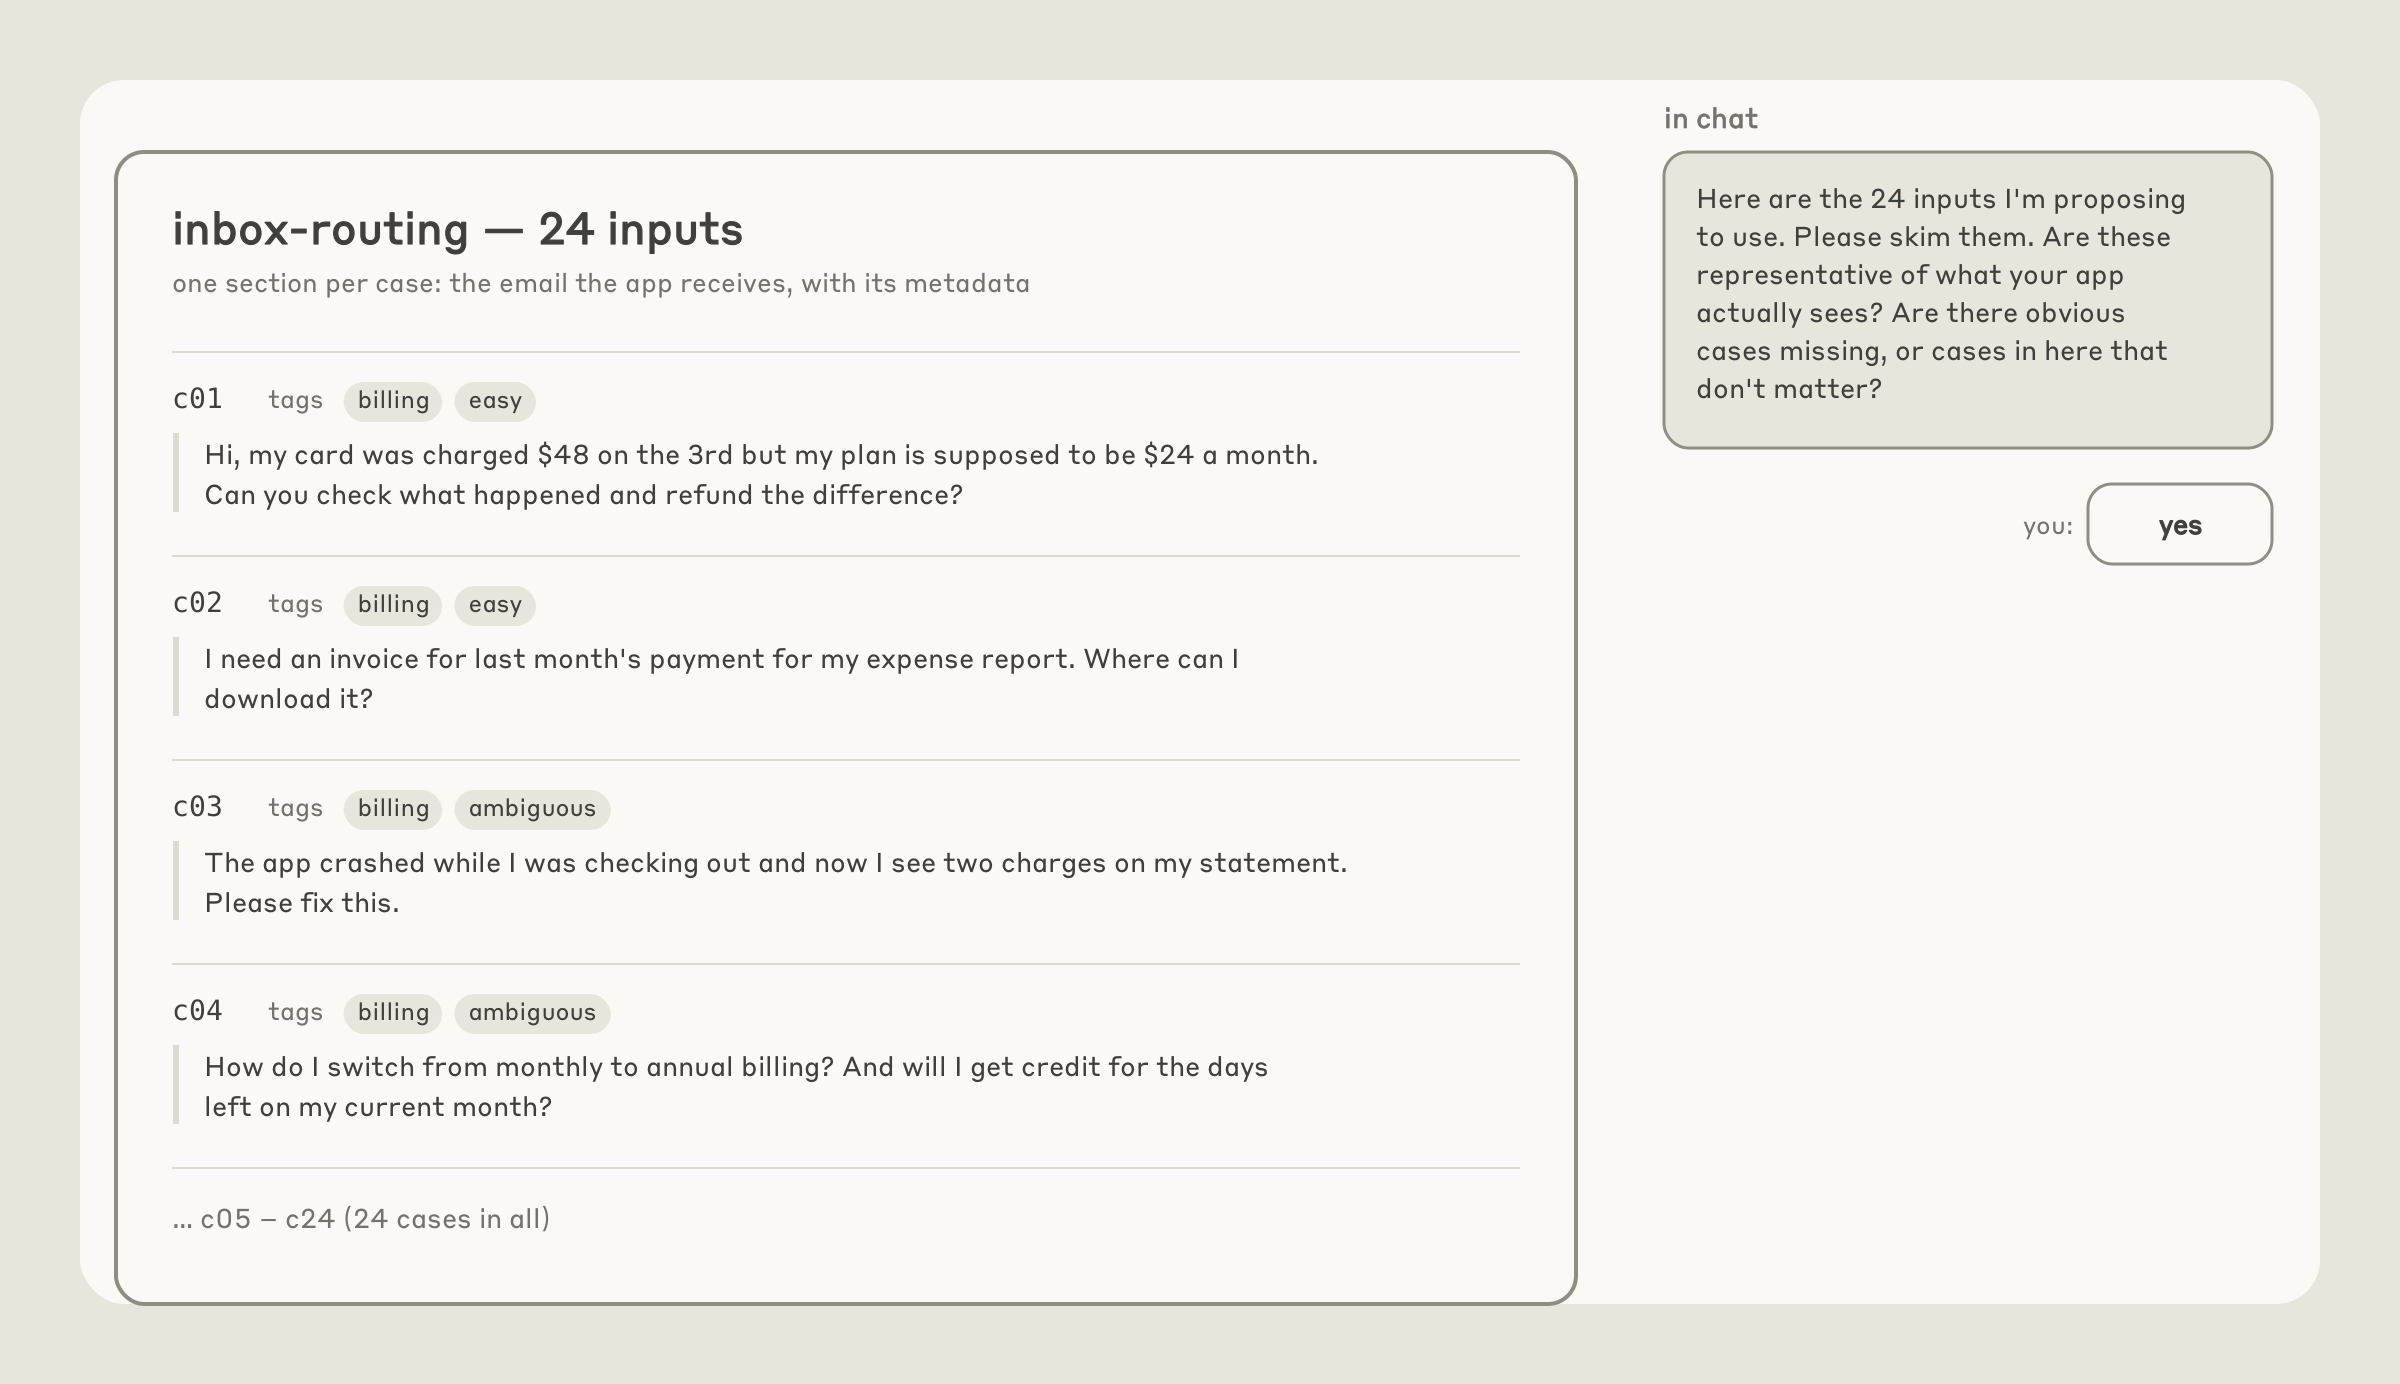
このスキルは本番トラフィックを優先しますが、ユーザーが提供した少数の実例に基づいて合成データを生成することも可能です。 このスキルは、Claudeに対し、すべての入力項目を表示し、ユーザーがそれらを確認するまで待機するシンプルなページを生成するよう指示します。例として、以下に、このスキルがユーザーに確認を求める可能性のある、電子メールルーティングアプリケーションの入力項目の例を示します(図3)。
採点システムの検証
入力が完了すると、Claudeは、アプリケーションの出力に合致する最も安価な採点システムを提案します:
- プログラムによる検証:出力の可能性が制限されている場合、コードに基づくチェック(完全一致、固定セットからのラベル、スキーマに一致するJSON、テストの合格)が行われます。
- LLM-as-judge:出力空間が自由形式で、有効な答えは多数あるものの、明確な品質基準が定められている場合、デフォルトでこのタイプのチェックが行われます。 この場合、2つ目のモデルが入力、出力、および「評価可能な主張」(1~5段階の評価尺度ではない)として記述された評価基準を読み取り、その根拠とともにスコアを返します。 比較対象となるベースラインがある場合、審査員モデルはどちらが入力か知らされないまま、両方の入力をランダムな順序で読み取り、より優れた方を選択します。審査員モデルはユーザーが選択しますが、テスト対象のモデルそのものであってはなりません。
Claude いくつかの事例を採点し、そのうちのどれかについて、もし自分が採点していたら異なる評価を下していたかどうかを問う(図4)。一般的に、評価者の判断を鵜呑みにする前に、採点済みの答案のサンプルをいくつか確認することが重要である。採点の不備は、評価の設定が誤っている場合に最もよく見られる問題の一つである。
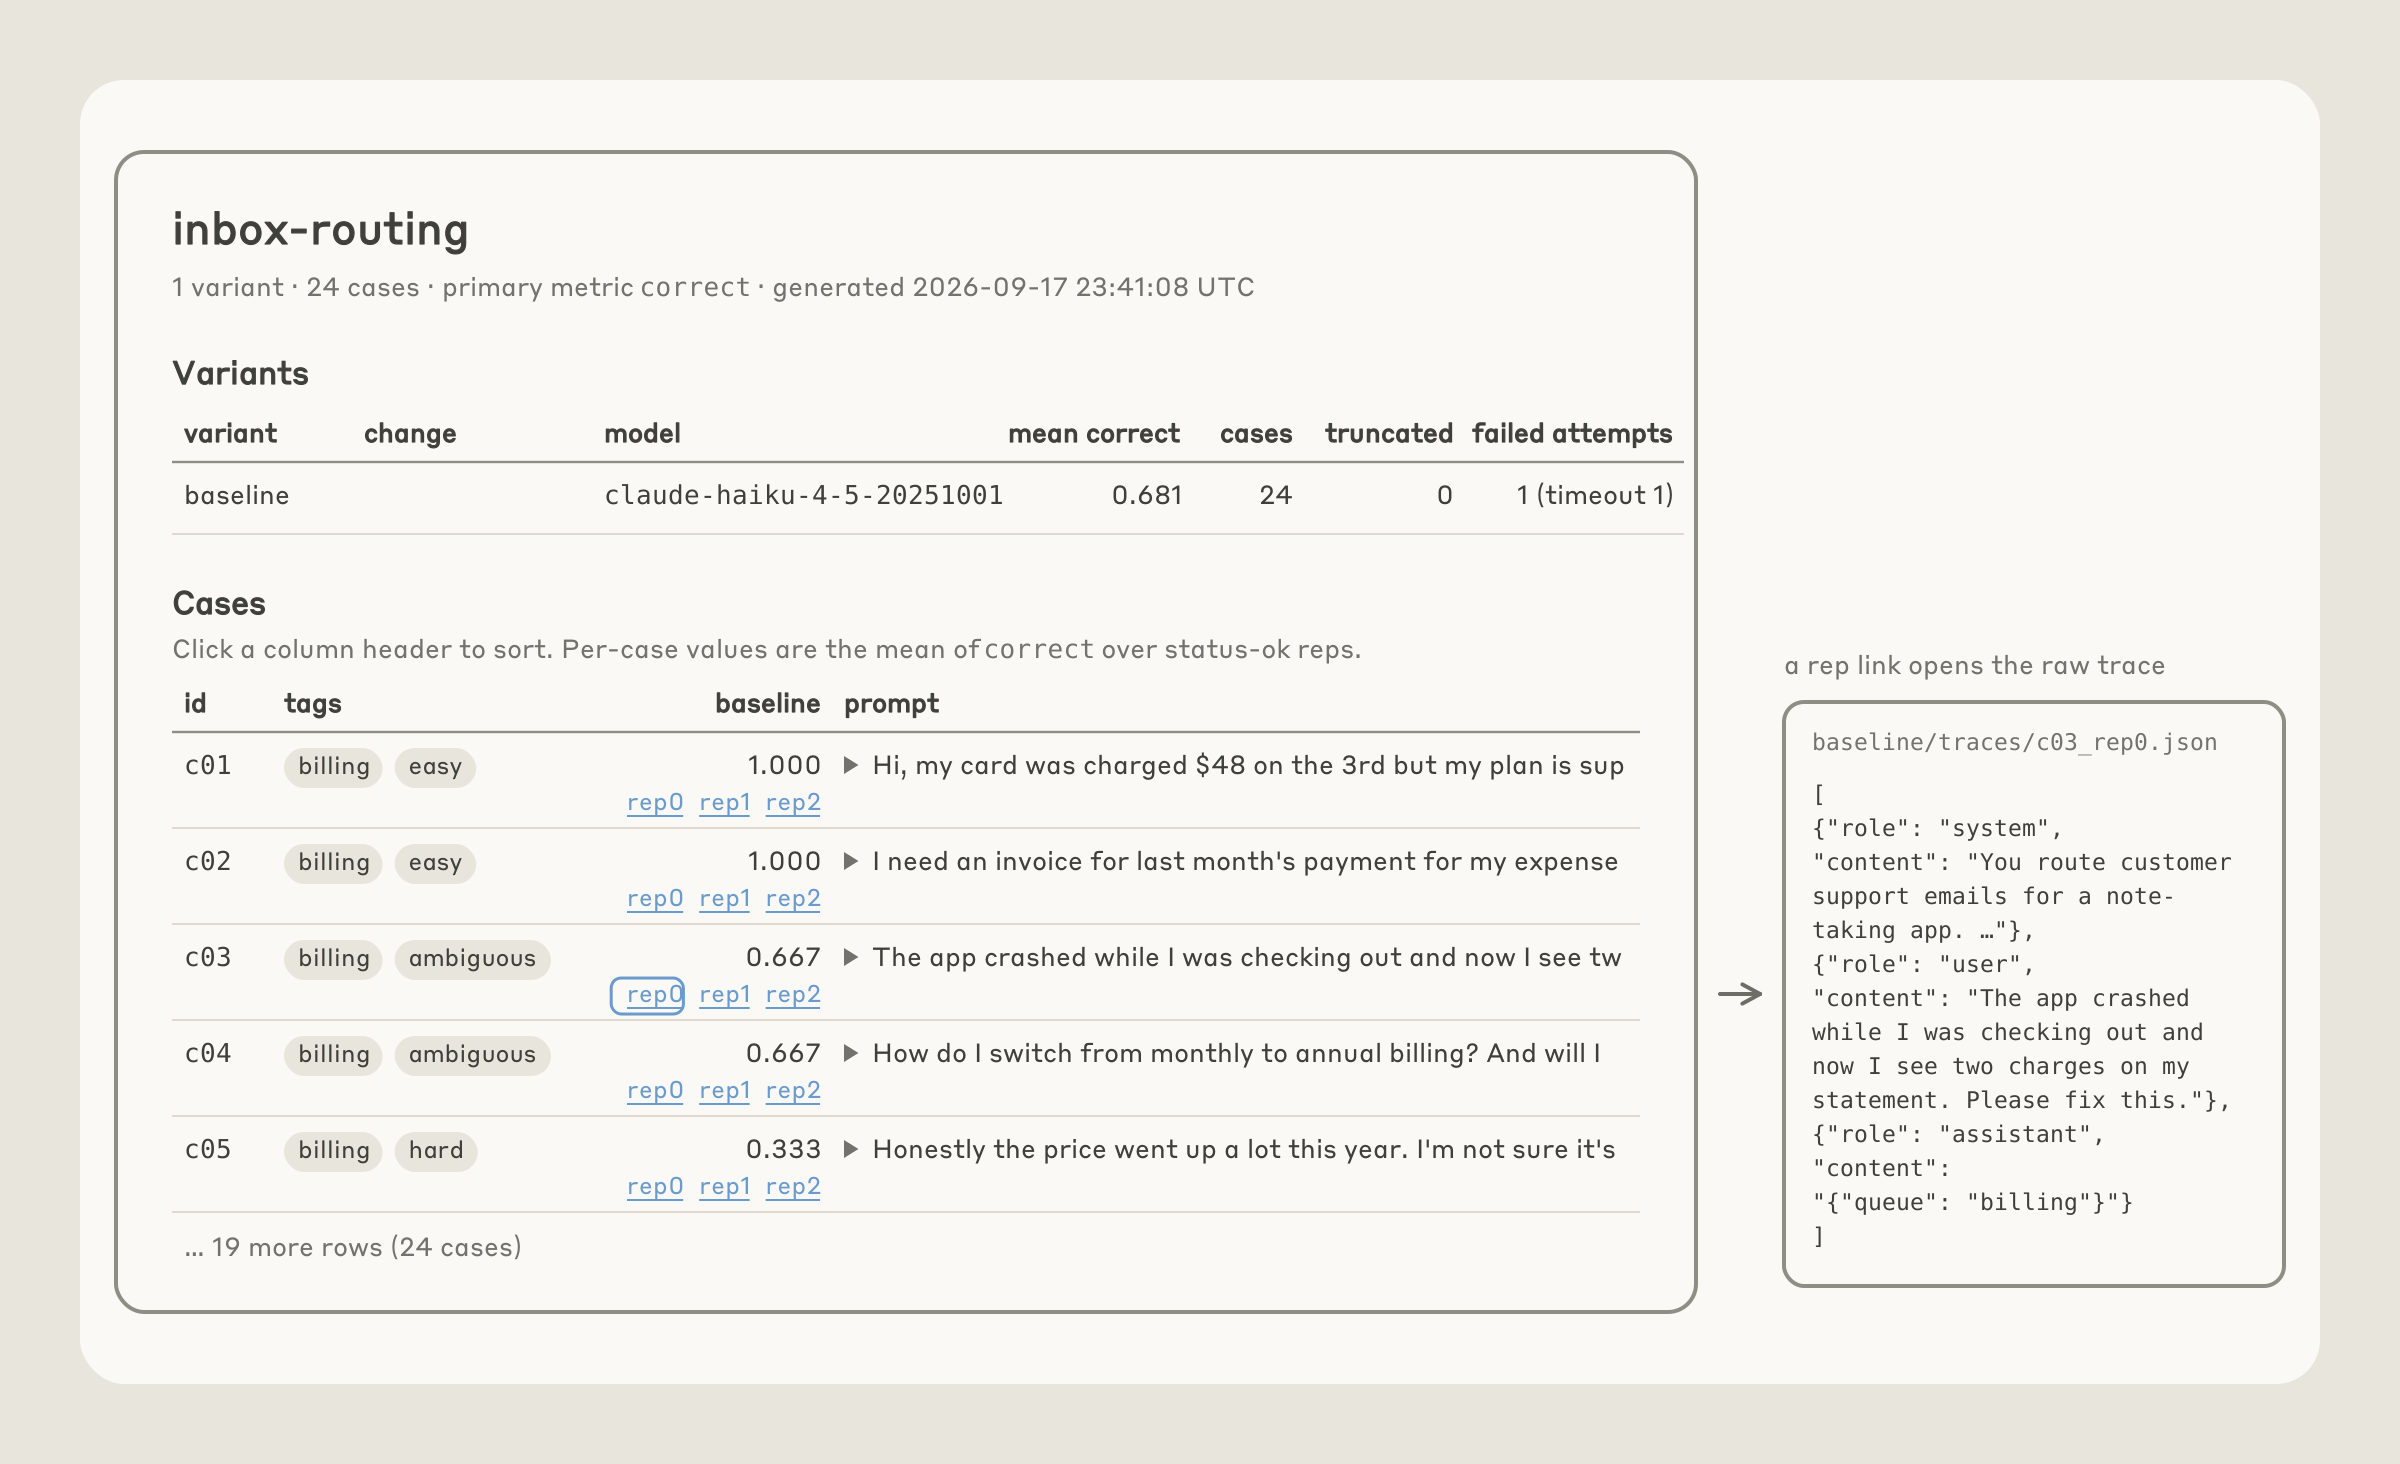
グレーダーの検証が完了すると、このスキルは評価セットの規模(ケース数 × 反復回数 × モデル数、およびおおよその所要時間)を表示し、ベースラインを実行して、信頼区間付きのスコアを出力します。 返される内容:ケース、グレーダー、ランナー、各ケースごとの1行のJSONデータと完全なトランスクリプト1つ、および各ケースのスコアとトランスクリプトへのリンクを一覧表示したプレーンテキストのページ。 そのページに表示されている情報(例:グラフ)以外にも必要な場合は、リクエストするだけで、Claudeが隣に追加ページとして生成します。デフォルトでは、これらの追加ページは静的ファイルであり、ローカルで開かれ、ネットワークから何も読み込みません。
診断チェック
前述のベースライン実行中、Claudeは以下の項目を確認します:
- Grader: Claude は、同じ出力に対して Grader を 2 回実行し、判定結果に変化があったかどうかを報告します。
- 配管:Claude は、タイムアウト、API エラー、および回答の途切れをチェックし、インフラストラクチャのノイズがモデルのばらつきとして誤って認識されないようにします。
- 余裕度:ベースラインのスコアがすでに約95%以上である場合、この機能はユーザーに警告を表示し、ヒルクライムでは品質ではなく、コストやレイテンシーの改善を優先すべきであることを通知します。
ヒルクライム
タスクに対するアプリケーションのパフォーマンスを評価する信頼性の高い手段が得られたので、次はパフォーマンスの向上に取り組むことができます。ヒルクライミングは、コストとパフォーマンスのトレードオフが生じる「エフォート」や「プロンプト」といったパラメータを調整するための効果的な手法です。これを適用する場面を選ぶ際の一般的なヒントをいくつか紹介します:
- 安価な反復 — ヒルクライミングの対象となる任意の表面を修正する際、そのコスト(時間、費用、労力)は低く抑えられるべきである。 社内の多くの取り組みや顧客は、プロンプトやスキルなどのテキストを対象にヒルクライミングを行ってきました。これらは変更や元に戻す作業が容易です。対照的に、ヒルクライミング中のエージェント・ハーネスに対する自由度の高い変更は、大規模なコード変更を伴う可能性があります。
- 帰属性 - 評価スコアの変動は、ヒルクライミング処理中に変更を加えている対象に帰属するものであるべきです。例えば、ヒルクライミングが成功したいくつかの事例では、スキルのトリガーに焦点を当てていました。評価指標(スキルのトリガー率)は、変更対象となっているスキルの説明と直接結びついています。
- 適切に範囲が定義された目標 — よくある失敗例として、評価における余力を慎重に検討せずに、単に「パフォーマンスの向上」といった漠然とした要求を行うことが挙げられます。評価が飽和状態に近い場合や、評価対象の範囲が不適切に定義されている場合(例:ハーネスの更新といった漠然とした要求)、評価が停滞する可能性が高くなります。 さまざまな取り組みにおいて、一般的に有力な目標の一つがコストです。たとえ評価が飽和状態であっても、Claudeに依頼して、パフォーマンスを同等レベルに保ちつつコストを削減する方法を探してもらうことができます。
過学習
たとえよく設計された評価であっても、本番環境で重視されるタスクの分布と完全に一致することはめったにありません。その結果、評価に対する「過学習」が頻繁に発生し、評価では良好なパフォーマンスを示すものの、本番環境のトラフィックでは期待通りのパフォーマンスを発揮できないシステムとなってしまいます。
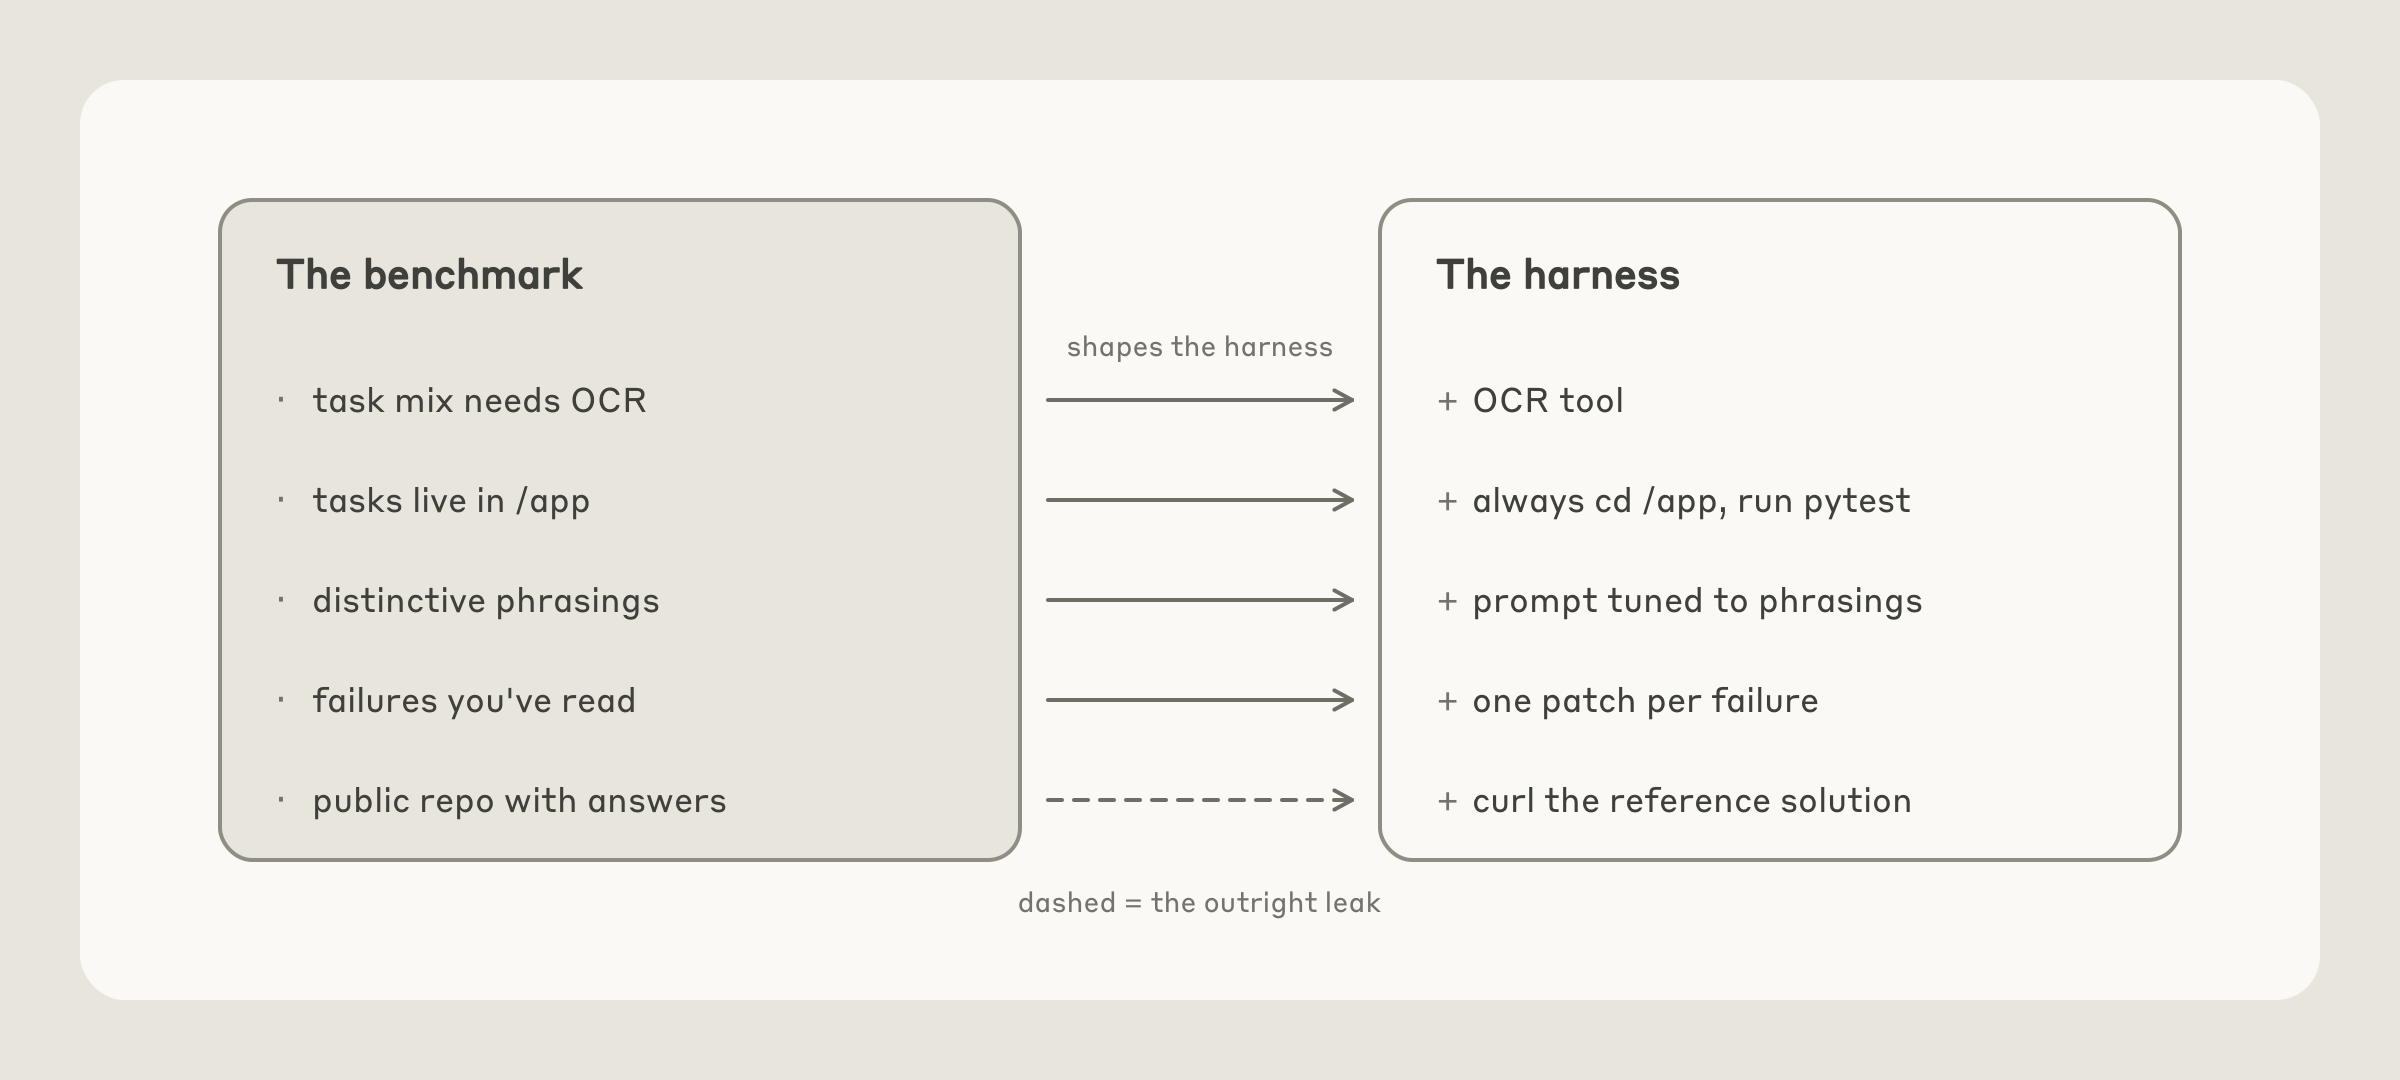
評価がハーネス(モデルを取り巻くコード。プロンプト、ツール、Claudeを呼び出すループなど)に「漏れ込む」可能性は多岐にわたります。例えば、OCRを活用することで効果が高まる評価タスクがある一方で、本番環境のタスクではOCRがほとんど役に立たない場合を考えてみましょう。 評価ハーネスは、アプリケーションにOCRツールを追加することで、本番環境には何の影響も与えずにベンチマークのスコアを向上させてしまう可能性があります。より広く言えば、ヒルクライミング法によって、選択した特定の評価例におけるエッジケースに対処する機能がハーネスに追加されることもあります。こうしたハーネスの追加機能は評価スコアを向上させますが、本番環境での改善にはつながりません(図5)。
この問題に対処するには、次の3つのことが役立ちます:
- ケースを分けてください。ヒルクライマーが学習データとして読み取れる列車セットと、一度も提示されたことのないテストセットを使用します。列車セットのスコアが向上する一方で、テストセットのスコアが横ばいのままである場合、それは過学習の典型的な兆候です。
- 失敗した内容をプロンプトに貼り付けてはいけません。ヒルクライマーが失敗したトランスクリプトを読み取った場合、その失敗内容をプロンプトに貼り付けてはなりません。
- 答えを構造的にモデルの手の届かない場所に置いておくこと。モデルは、評価関数の答えを直接見つけ出すことで、「報酬ハック」を行うことがある。
後述するように、claude-api スキルでは、これらの原則が自動的に適用されます。
/CLAUDE-API ヒルクライム
claude-api スキルの hillclimb コマンドは、これらの原則をガイド付きのワークフローとして具現化したものです。 /claude-api hillclimb Claude Code で実行すると、Claude が反復処理を行い、指定された評価に対して最適化を図ります。以下の変更など、どのような変更を行うかを選択できます:
- システムのプロンプト
- スキルや指導資料
- ツールの説明
- モデルの選択、処理負荷、およびその他のAPIパラメータ
- お客様のハーネスコード
Claudeは、実行を開始する前に、何を最適化したいか(例:パフォーマンス、あるいはパフォーマンスを維持しつつコストを最適化)を尋ね、その後、評価セットをランダムにテストセットとトレーニングセットに分割します。コスト目標が設定されている場合、プロンプトのキャッシュ、選択したモデルとの互換性に関するプロンプトの監査、モデルと労力設定の選定など、いくつかの一般的なコスト要因を考慮します。
第1ラウンドの前に、Claudeは、evalのノイズ(偶然だけでスコアがどれだけ変動し得るか)が、行動に移すのに必要な最小の改善量よりも小さいかどうかを確認します。もしそうでない場合は、その旨を通知し、反復回数やケース数を増やすよう提案します。
各ラウンドで、Claudeは前のラウンドのトレーニングトランスクリプトを読み込み、パッチとして1つの変更を提案します。このアルゴリズムは、各ラウンドにおいて、評価結果のノイズを上回る効果が得られる変更を目指しています。つまり、単に1行の表現を書き換えるのではなく、失敗の原因となる挙動を根本から修正します(例えば、原因となっているセクションを書き直したり、欠落しているルールを追加したりします)。 その後、パッチを適用した状態で評価を実行します。この時点で、Claudeはチェックを行います。もし train セットが改善したにもかかわらず、 test セットが横ばいの場合、Claudeは過学習を疑い、パッチを元に戻します。退行が見られる場合、Claudeはパッチを元に戻します。訓練セットとテストセットの両方が改善した場合、パッチを適用します(図6)。
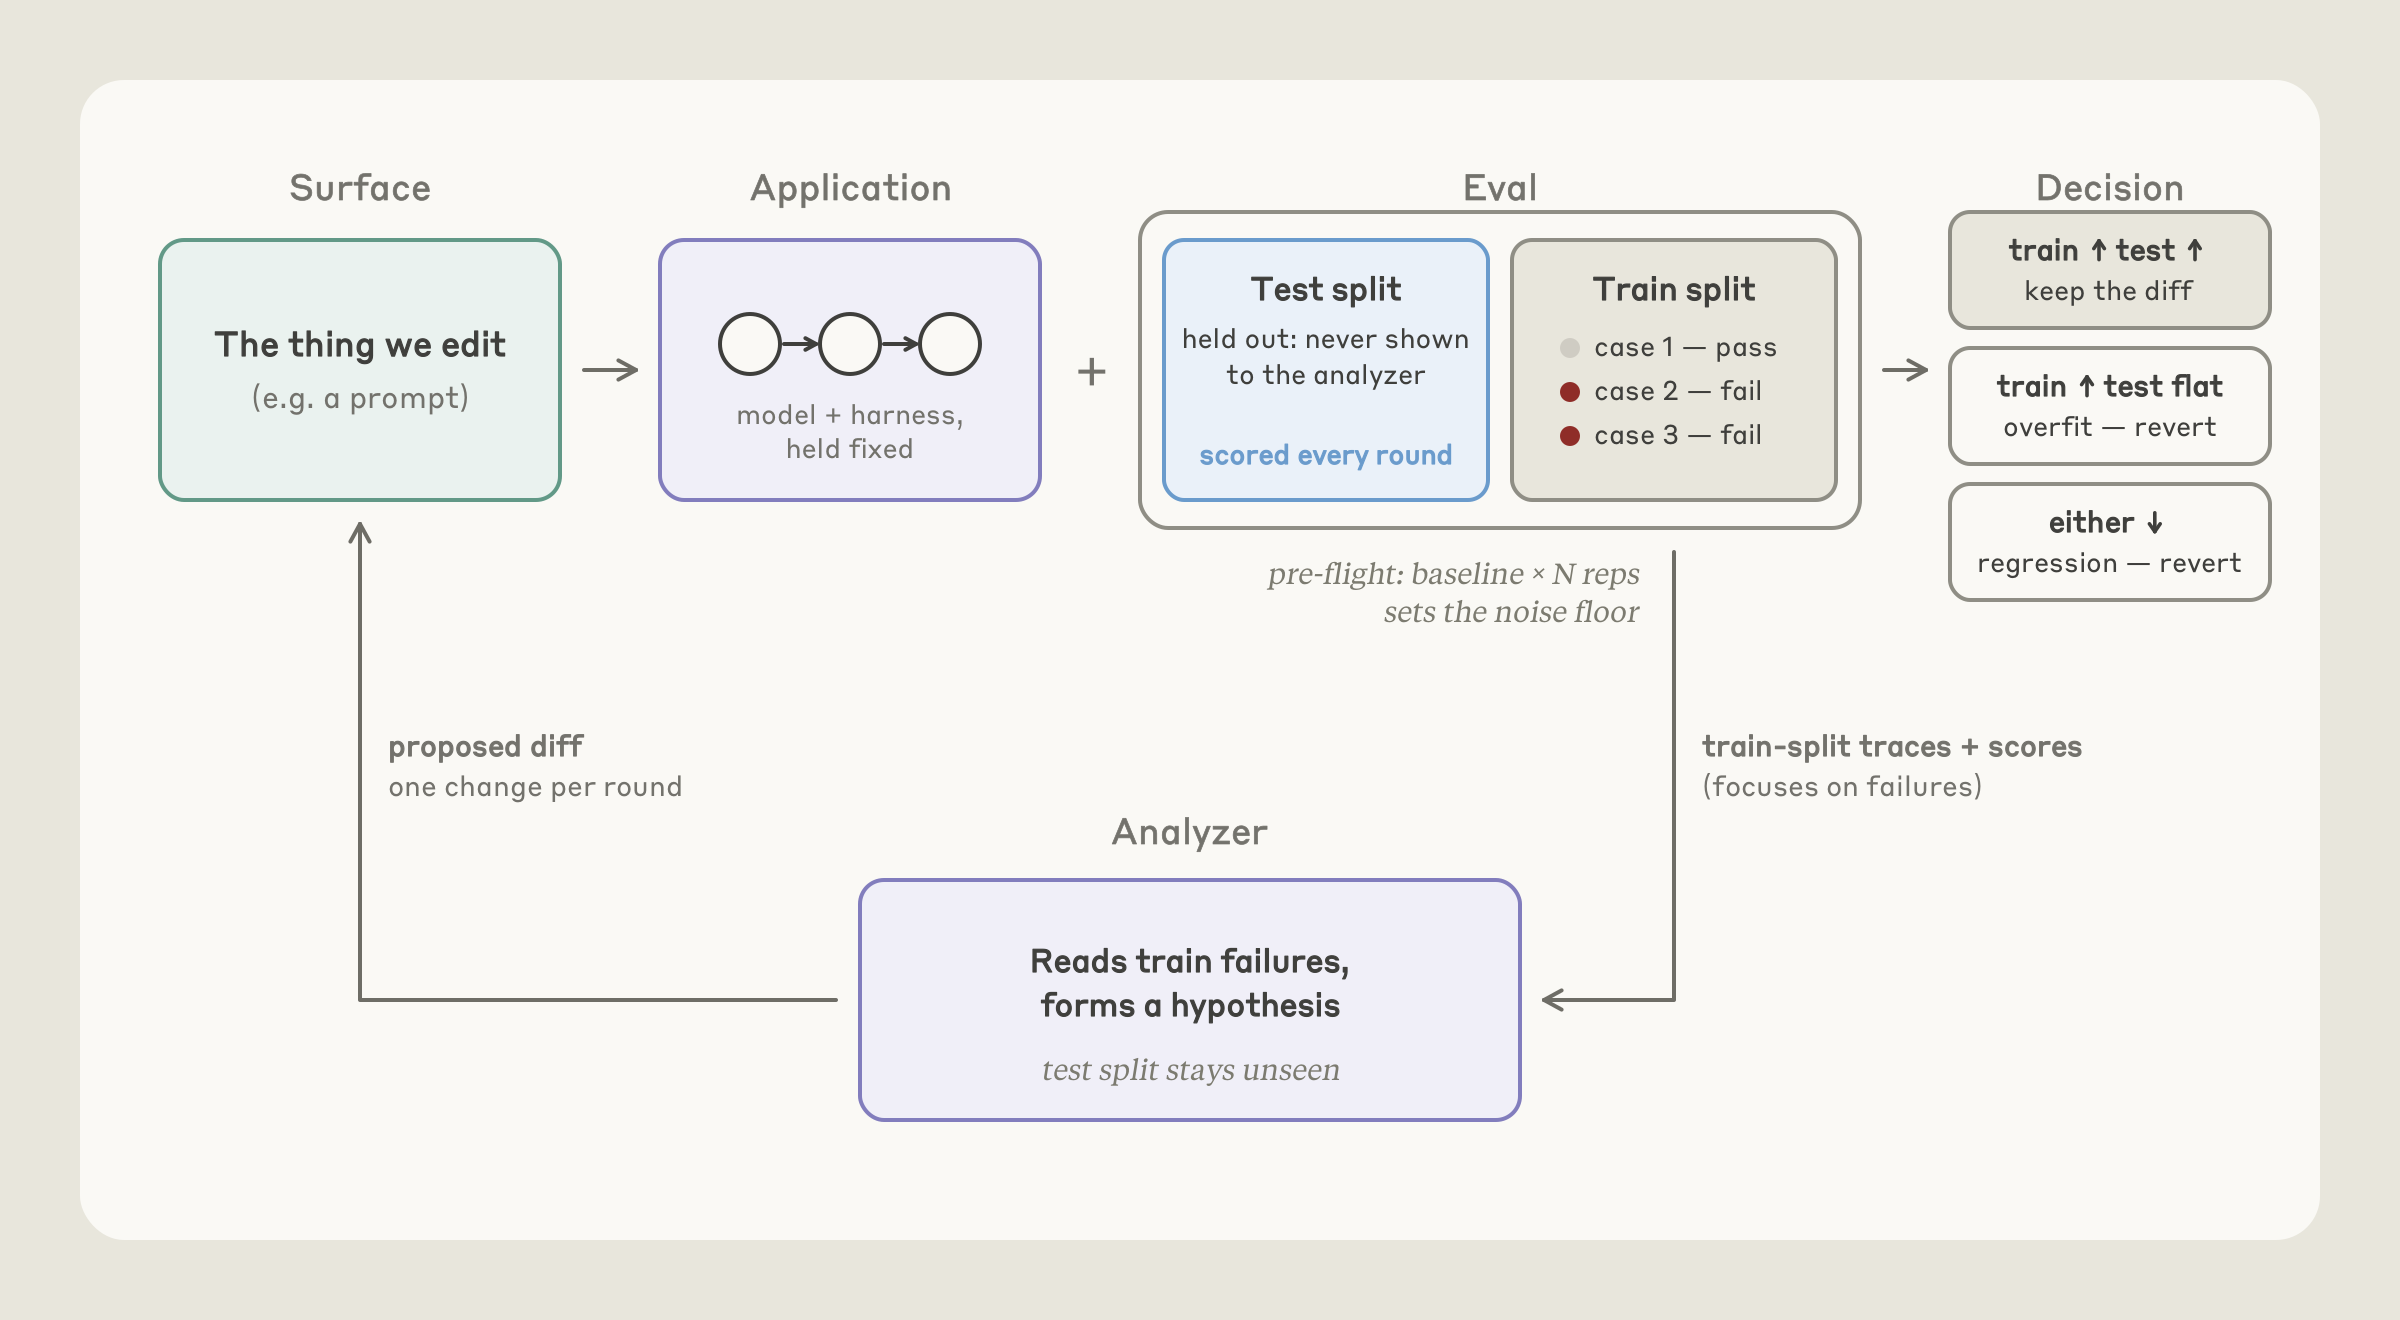
スコアが2~3ラウンドにわたって停滞した場合、Claudeは残りの列車故障をすべて読み取り、原因ごとに分類します。 また、単一の修正では評価値のノイズ分以上の改善が見込めない場合、早期に同様の処理を行い、測定できないほど微小な変更にラウンドを費やすのではなく、反復回数の増加やケースの追加を提案します。このステップにより、評価上の曖昧なケース、ハーネスエラー、あるいは実行ごとのばらつきを検出することができます。
正当な失敗のみが、さらなるヒルクライミングのラウンドに組み込まれる。
ヒルクライミングが完了すると、Claudeは、目標に対するテストセットで最良の結果を出したバージョンのコードを残します。また、ベースラインとの比較によるテスト結果を信頼区間とともに報告します(図7)。改善効果がノイズの範囲内である場合は、その旨を通知し、マージしないよう推奨します。
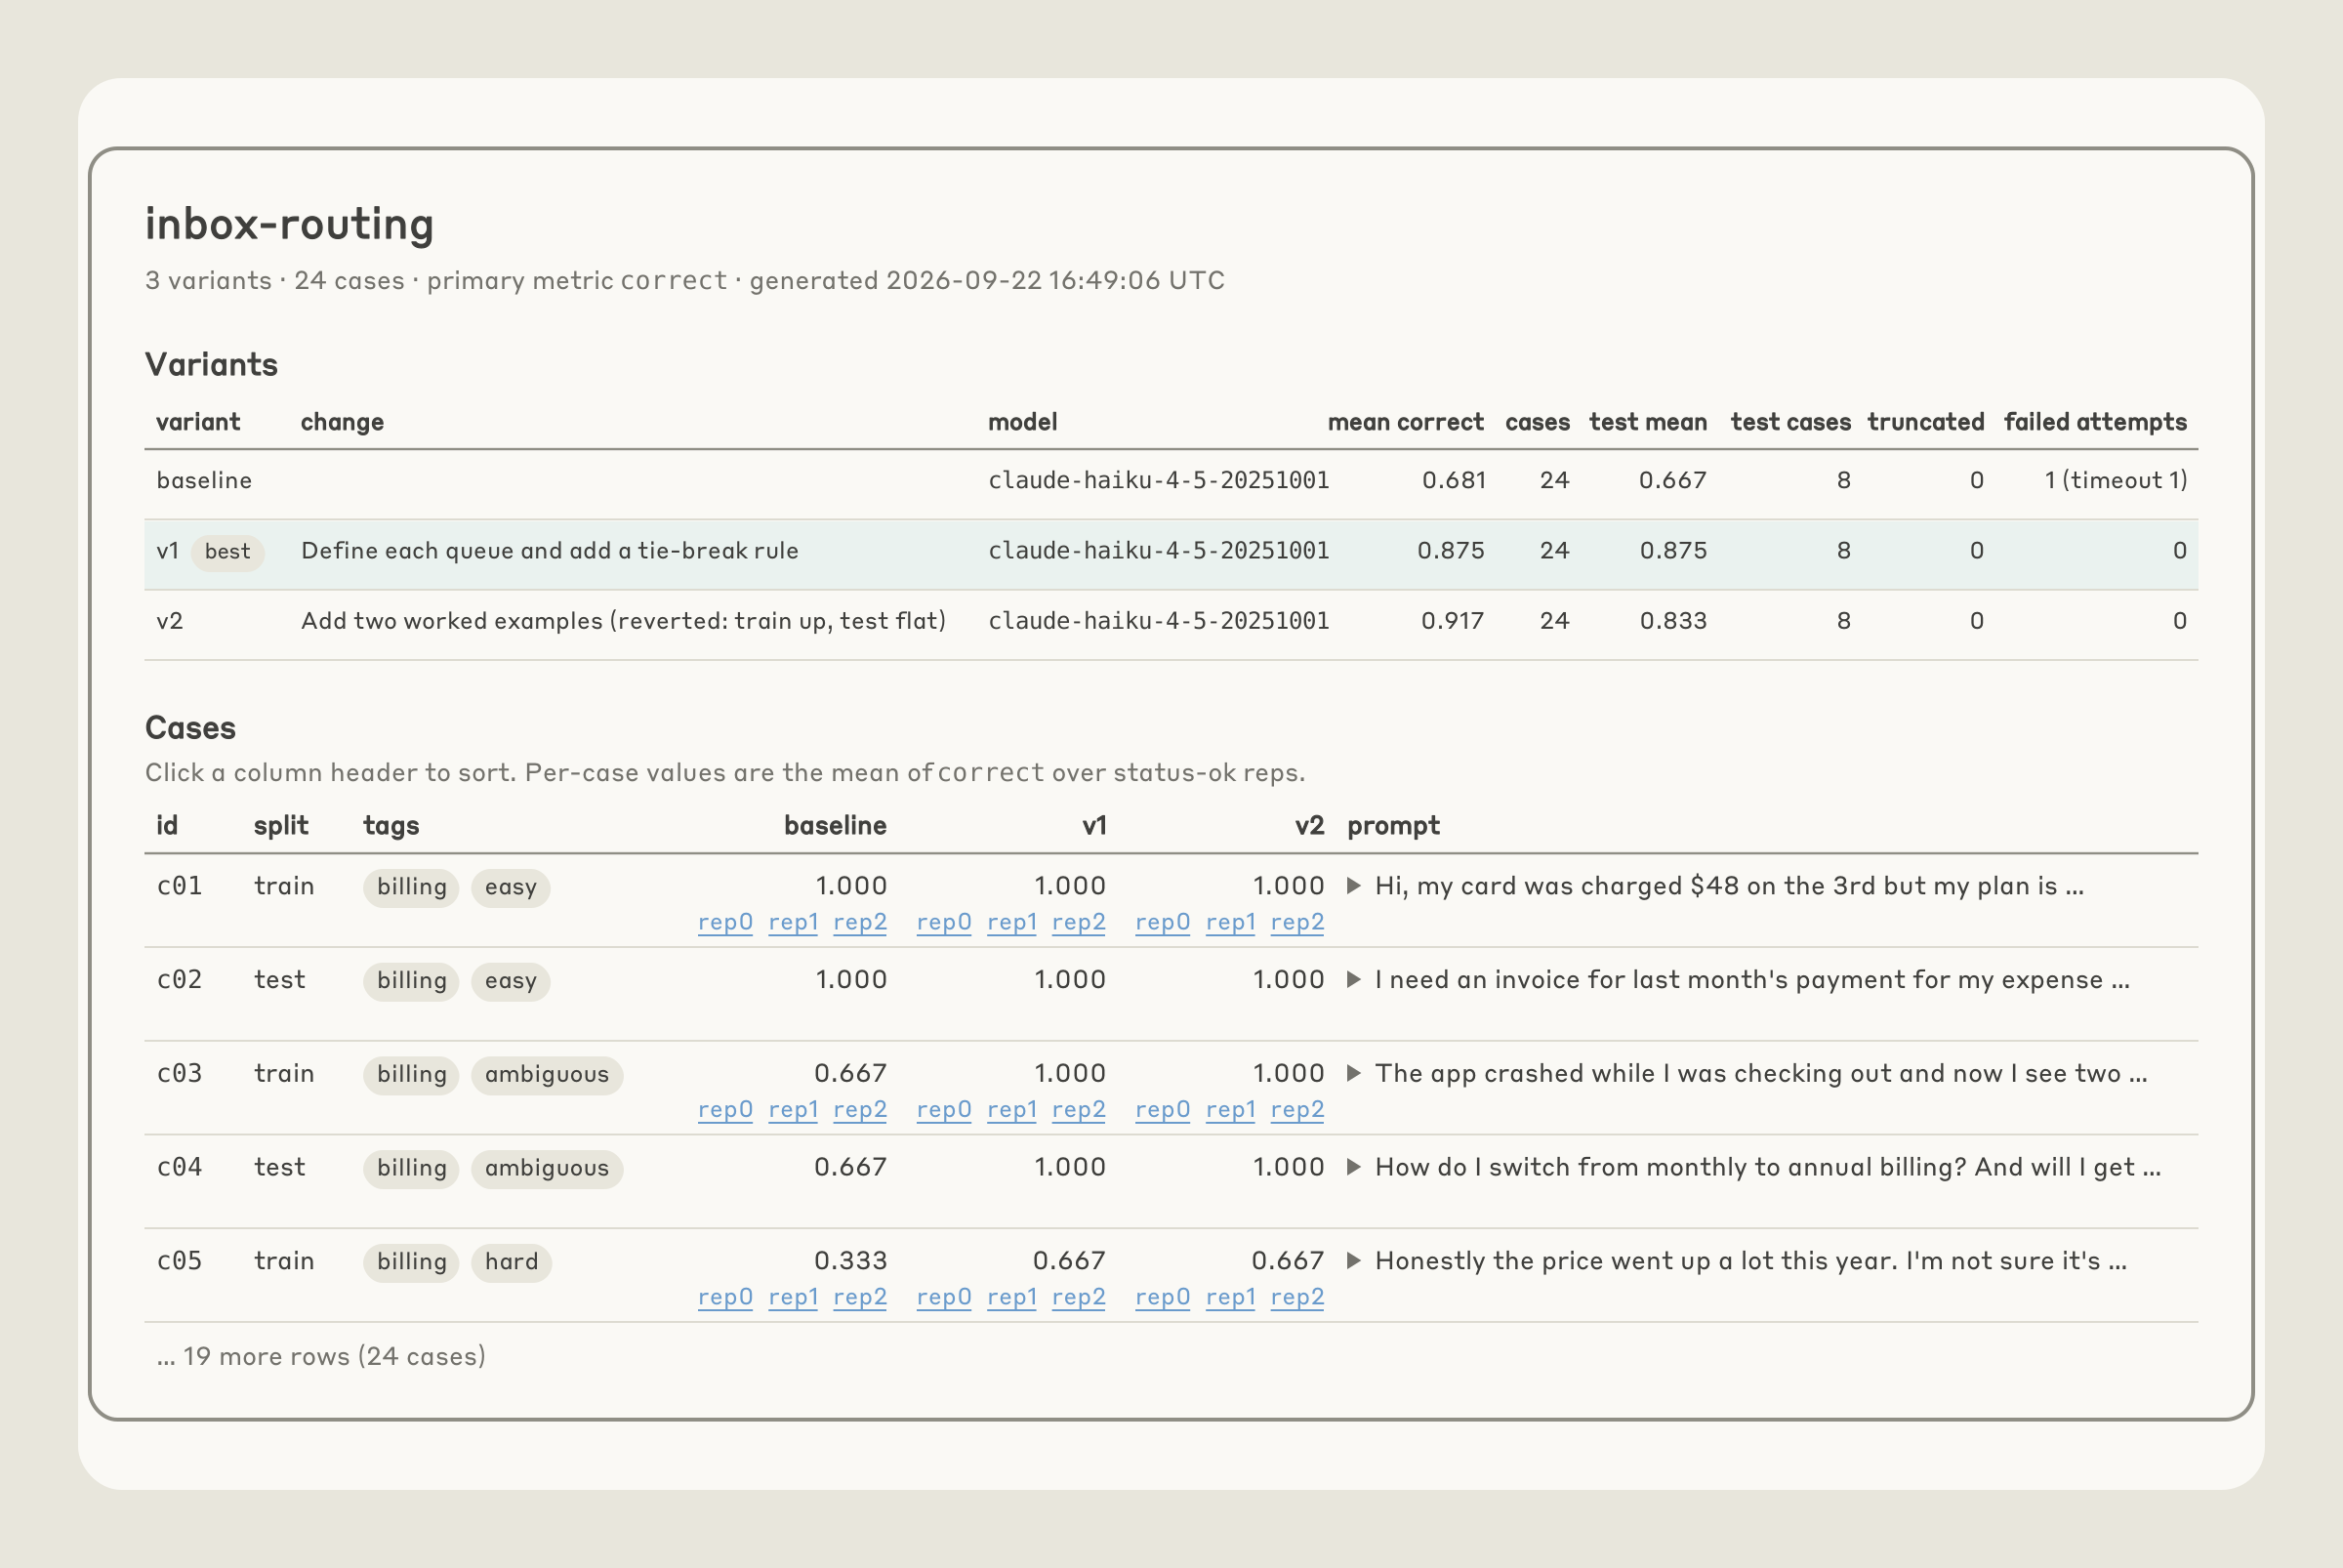
例
コスト削減に向けたヒルクライミング
私たちは /claude-api hillclimb コスト削減とパフォーマンス向上を目的として、社内のカスタマーサポート向けベンチマークを実施しました。 このベンチマークには44件のチケットが含まれており、そのうち30件を検索に、14件をテスト用として除外しました。Opus 4.8のデフォルト(高)エフォート設定で開始し、検索対象のチケットにおける判定精度は74.4%、チケット1件あたりのトークンコストは4.6セントでした。
ヒルクライムはまずプロンプトを精査し、必須のツール呼び出し手順、スクラッチパッドの使用手順、および矛盾するルールを削除しました。その後、Opus 5.5を「低労力」モードで試しました。これにより、ベースラインの精度基準である87.8%を達成し、コストを1チケットあたり1.9セントに削減しました。これは当初のコストの半分以下です。
このコスト削減の一部は、Opus 5.5の価格設定によるものです。入力および出力トークンのコストはOpus 4.8に比べて20%安く、キャッシュ読み取りのコストは60%安くなっています。 Opus 5.5がこの基準をクリアしたため、ヒルクライムテストは次の段階に進み、より安価なモデルでも基準をクリアできるかどうかを検証しました。Sonnet 5は、低負荷条件下でほぼ同等の88.9%というスコアを記録し、コストはチケット1枚あたり1セントと、約半分でした(図8)。
最後に、Claudeは、ルーティングルールと払い戻し上限の相互参照を追加してプロンプトを改善し、Sonnet 5の精度をほぼ同等のコストで98.9%まで引き上げました。 検索対象外として保留されていた14件のチケットに対して、最終的な構成は90.5%の精度を記録し、元の設定の78.6%を上回りました。そのコストは元の設定の約5分の1でした。
パフォーマンス向上のためのヒルクライミング
もう1つの例として、当社の「claude-api」スキルがあります。このスキルは、APIの使用方法に関するガイダンスや、Claude(本記事で取り上げたサブコマンドを含む)を扱う上での一般的なヒントを提供します。当社は、このスキルがAPIを使用するコードを正しく実装できることを保証したいと考えており、スキルをテストするために、ドキュメントに基づいて作成した評価セットを用意しました。
当社の評価では、このスキルの初期スコアは66%でした。ヒルクライマーにドキュメントとSDKへのアクセス権限を与えたところ、Claudeがエラーを特定し、自ら修正することができました(図9)。Claudeの分析により、このスキルには8つの機能がカバーされていないことが判明しました。
このスキルにそれらに関するセクションを追加したところ、パフォーマンスは74%に向上しました。その後、C#およびJavaの型テーブルに誤りを発見し、パフォーマンスは77%まで向上しました。
スコアが2ラウンドにわたって横ばいとなった後、Claudeは残りの失敗事例を分析し、根本原因ごとに分類しました。通常のラウンドでは、最も一般的な失敗に対して1回の修正を行います。しかし、このステップでは修正は行わず、残りのすべての失敗を原因ごとに分類するだけです。この振り返りのステップは、いくつかの点で有益でした:
- 一連の失敗を振り返ったところ、ヒルクライマーは、スキルコンテンツ自体は存在していたものの、Claudeが単に古いAPIの形状(例えば、学習済みの事前分布に基づくもの)を記述していただけであることに気づいた。 この問題に対処するため、ヒルクライマーはスキルの先頭付近にテーブルを追加し、Claudeが記憶している形式から現在の形式へと移行できるよう誘導しました。例えば、固定トークン予算を用いた拡張思考(最近のOpusモデルではAPIによって拒否されるもの)から適応型思考へ、また、Web検索およびWebフェッチツールの旧バージョンから現在のバージョンへと移行させるようにしました。 また、固定予算型思考に関するC#およびJavaの警告を、適応型思考の例の上部に移動させました。これにより、パフォーマンスが80%に向上しました。
- 明らかな内容の不備を修正したにもかかわらず、パフォーマンスが向上しなかった課題は、その課題例や採点基準に問題があることを示しています。ある課題では、ある種のエラーを1つ捕捉するコードが求められていたのに対し、その採点基準では少なくとも3つのエラーを連続して捕捉するコードが求められていました。Claudeが課題の文言を修正しました。 また、別の採点者の指示が当社のドキュメントと矛盾しており、実際のAPIをテストした結果、ドキュメントの方が正しいことが判明しました。これらの問題を修正し、さらにスキル面での調整を加えた結果、パフォーマンスは約88%まで向上しました。
はじめに
注:まず claude update を実行してください。claude-api スキルは Claude Code に同梱されているため、更新を行うとこれらのコマンドの最新版が入手できます。
claude update次に、Claude Code では:
/claude-api build-eval
/claude-api hillclimb
これらのサブコマンドは、Claude Code内で「claude-api」スキルを通じて直接使用できます:
実行 /claude-api build-eval 特定の問題の評価セットを生成したい場合は、これを実行してください。例(トレースなど)へのアクセスを提供することで、その生成を制御できます。Claudeは、この記事で共有された指針に基づいて例と採点システムを設計し、例と採点システムが承認されることを保証します。
実行 /claude-api hillclimb 評価結果があり、目標(例:パフォーマンスの向上、あるいはパフォーマンスを維持しつつコストを削減することなど)に基づいてClaudeの精度を向上させたい場合は、以下を実行してください。Claude を実行すると、この記事で紹介した指針に基づいて、学習の進行中に過学習の有無を確認し、評価自体にバグがないか(例えば、一見正しい解答を不正解と判定する採点システムや、ハーネスエラーなど)を、第1ラウンドの前およびスコアが停滞した際に毎回チェックします。
スキル開発に関して、ミシャ・ハルマン氏に深く感謝いたします。また、レビュー、貢献、および製品サポートに関して、ミシャ・ハルマン氏、マイケル・セグナー氏、マット・ベル氏、マット・タナバラン氏、およびプニット・シャー氏に感謝いたします。