Claude Codeの構築から得た教訓:スキルの活用方法
Lessons from building Claude Code: How we use skills
この記事は 原文 を DeepL で機械翻訳したものである。正確な内容は原文を参照のこと。
スキルは、Claude Codeにおいて最も頻繁に利用される拡張ポイントの一つとなっています。スキルは柔軟性が高く、作成も配布も簡単です。
しかし、この柔軟性ゆえに、何が最も効果的かを見極めるのが難しくなります。どのようなスキルを作る価値があるのでしょうか?スキルはどのように構成すべきでしょうか?いつ他の人と共有すべきでしょうか?
Anthropic では、Claude Codeのスキルを幅広く活用しており、現在も数百のスキルが実際に稼働しています。ここでは、スキルを活用して開発を加速させる上で私たちが得た知見をご紹介します。
「スキル」とは何でしょうか?
スキルとは、エージェントが参照して利用することで、より正確かつ効率的にタスクを実行できるようになる、指示、スクリプト、リソースをまとめたフォルダのことです。このブログ記事では、スキルの基礎知識をお持ちであることを前提としています。初めての方は、Skilljarの「エージェントスキル入門」コースから始めてください。
スキルに関してよく耳にする誤解の一つに、「スキルは単なるマークダウンファイルに過ぎない」というものがあります。実際には、スキルはフォルダであり、エージェントが検出して探索し、操作できるスクリプト、アセット、データなどを含めることができます。
Claude Code では、スキルには動的フックの登録など、さまざまな設定オプションが用意されています。
Claude Codeにおいて、最も効果的なスキルのいくつかは、これらの設定オプションやフォルダ構造を効果的に活用していることがわかりました。
スキルの種類
Anthropicで社内のスキルをすべて整理したところ、それらが9つのカテゴリーに分類されることがわかりました。最適なスキルは1つのカテゴリーにすっきりと収まりますが、やりすぎようとするスキルは複数のカテゴリーにまたがり、エージェントを混乱させてしまいます。これは決定的なリストではありませんが、自社のスキルライブラリにおける不足部分を特定するための有用な枠組みとなります。
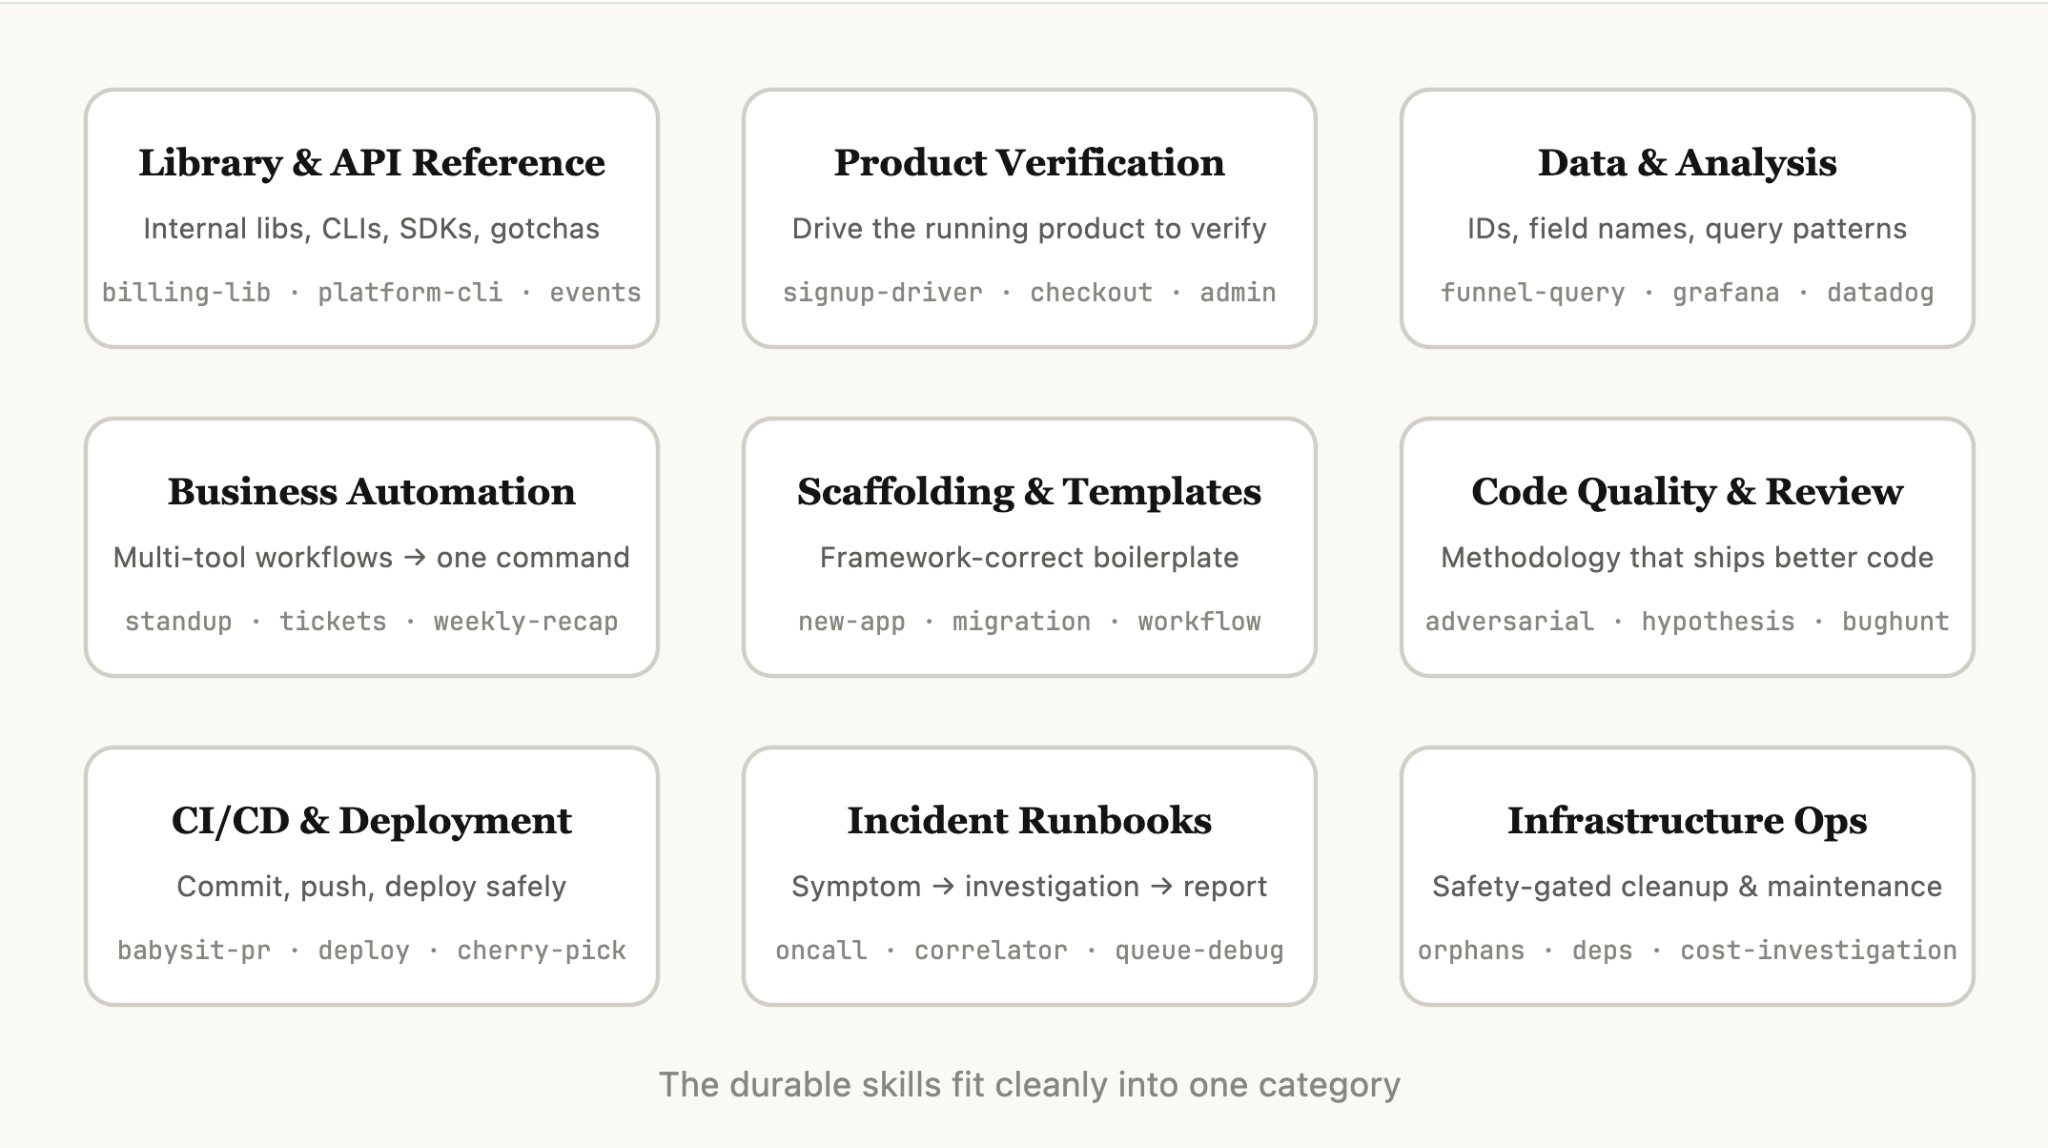
1. ライブラリおよびAPIリファレンス
これらは、ライブラリ、CLI、またはSDKを正しく使用する方法について解説したスキルです。これらは、内部ライブラリだけでなく、Claude Codeが扱いにくさを感じることがある一般的なライブラリに関するものも含まれます。こうしたスキルには、多くの場合、参照用のコードスニペットが収められたフォルダや、Claudeがスクリプトを作成する際に避けるべき注意点の一覧が含まれていました。
例としては、次のようなものがあります:
billing-lib— 社内の請求処理ライブラリ:エッジケースやフットガンなど。internal-platform-cli— 内部CLIラッパーのすべてのサブコマンドと、それぞれの使用例。sandbox-proxy— 開発作業に向けた組織のアウトバウンドゲートウェイの設定:アクセス可能なホスト、 「接続拒否」エラーのデバッグ方法、許可リストへのエントリの追加方法。
2. 製品の検証
これらは、コードが正常に動作しているかどうかをテストまたは検証する方法を示すスキルです。多くの場合、Playwrightやtmux、その他の外部検証ツールと組み合わせて使用されます。
検証スキルは、Claudeの社内における成果物の品質に、最も顕著な影響を与えてきました。エンジニアに1週間を費やしてもらい、検証スキルを卓越したレベルに引き上げることは、十分に価値のあることと言えます。
Claudeの出力を動画として記録し、具体的にどのようなテストが行われたかを確認できるようにしたり、各ステップで状態に対するプログラムによるアサーションを適用したりといった手法を検討してください。これらは、多くの場合、スキルにさまざまなスクリプトを組み込むことで実現されます。
例としては、次のようなものがあります:
signup-flow-driver— ヘッドレスブラウザ上で、登録 → メール認証 → オンボーディングの各ステップを実行し、各ステップで状態を確認するためのフックが用意されているcheckout-verifier— Stripeのテストカードを使用してチェックアウトUIを操作し、請求書が実際に正しい状態で生成されることを確認するtmux-cli-driver— 検証対象が TTY を必要とする、対話型の CLI テストの場合
3. データの取得と分析
これらは、データやモニタリング・スタックと連携するためのスキルです。これらのスキルには、認証情報や特定のダッシュボードIDなどを用いてデータを取得するためのライブラリのほか、一般的なワークフローやデータ取得方法に関する手順などが含まれる場合があります。
例としては、次のようなものがあります:
funnel-query— 「登録→アクティベーション→有料化」のプロセスを確認するにはどのイベントをトラッキングすればよいか、および正規の user_id が記載されたテーブルcohort-compare— 2つのコホートの継続率またはコンバージョン率を比較し、統計的に有意な差を特定し、セグメントの定義へのリンクを掲載するgrafana— データソースのUID、クラスタ名、問題 → ダッシュボードの参照テーブルdatadog— フィールド参照(@request_id 対 trace_id)、サービス一覧、メトリックプレフィックスの規則
4. ビジネスプロセスとチームの自動化
これらは、反復的なワークフローを1つのコマンドに自動化するスキルです。これらのスキルは通常、比較的単純な指示ですが、他のスキルやMCPとの間でより複雑な依存関係を持つ場合があります。こうしたスキルでは、以前の結果をログファイルに保存しておくことで、モデルの一貫性を保ち、ワークフローの過去の実行状況を反映させることができます。
例としては、次のようなものがあります:
standup-post— チケットトラッカー、GitHubのアクティビティ、および以前のSlackのデータを統合し、→ フォーマット済みのスタンドアップ形式で、差分のみを表示しますcreate-<ticket-system>-ticket— スキーマ(有効な列挙型値、必須フィールド)の遵守に加え、作成後のワークフロー(レビュー担当者に通知、Slackへのリンク)を適用しますweekly-recap— マージされたプルリクエスト + クローズされたチケット + デプロイ → 整理されたまとめ記事
5. コードのスケルトンとテンプレート
これらは、コードベース内の特定の関数に対してフレームワークのボイラープレートを生成するスキルです。これらのスキルを、組み合わせ可能なスクリプトと併用することもできます。特に、スキャフォールディングに、コードだけでは完全にカバーできない自然言語による要件がある場合に役立ちます。
例としては、次のようなものがあります:
new-<framework>-workflow— 指定したアノテーションを用いて、新しいサービス/ワークフロー/ハンドラーを構築しますnew-migration— 移行ファイルのテンプレートと、よくある落とし穴create-app— 認証、ロギング、デプロイの設定が事前に組み込まれた新しい社内向けアプリ
6. コードの品質とレビュー
これらは、組織内でコードの品質を確保し、コードのレビューを支援するスキルです。これには、堅牢性を最大限に高めるための決定論的なスクリプトやツールなどが含まれます。これらのスキルは、フックの一部として、あるいはGitHubアクション内で自動的に実行することをお勧めします。
adversarial-review— 新たな視点を持つサブエージェントを生成して批評を行わせ、修正を加え、指摘内容が些細な点に過ぎなくなるまでこのプロセスを繰り返すcode-style— コードスタイルを徹底させます。特に、Claudeがデフォルトではうまく処理できないスタイルについてです。testing-practices— テストの書き方や、何をテストすべきかについての説明。
7. CI/CD とデプロイ
これらは、コードベース内でコードを取得、プッシュ、デプロイするのに役立つスキルです。これらのスキルは、データを収集するために他のスキルを参照する場合があります。
例としては、次のようなものがあります:
babysit-pr— PRを監視 → 不安定なCIを再実行 → マージの競合を解決 → 自動マージを有効化deploy-<service>— ビルド → スモークテスト → エラー率の比較を伴う段階的なトラフィック展開 → 回帰が発生した際の自動ロールバックcherry-pick-prod— 独立したワークツリー → チェリーピック → 競合の解決 → テンプレートを使用したプルリクエスト
8. ランブック
これらは、症状(Slackのスレッド、アラート、エラーシグネチャなど)を基に、複数のツールを用いた調査手順を順を追って実行し、体系的なレポートを作成するスキルです。
例としては、次のようなものがあります:
<service>-debugging— 症状 → ツール → トラフィックが最も多いサービスにおけるクエリパターンを照合するoncall-runner— アラートを取得する → よくある原因を確認する → 調査結果をまとめるlog-correlator— リクエストIDが指定されると、そのリクエストに関与した可能性のあるすべてのシステムから、一致するログを取得します
9. インフラの運用
これらは、日常的な保守や運用手順を実行するためのスキルであり、その中にはガードレールの導入が有効となる破壊的な作業も含まれます。これにより、エンジニアは重要な作業においてベストプラクティスをより容易に遵守できるようになります。
例としては、次のようなものがあります:
<resource>-orphans— 孤立したポッド/ボリュームを検出 → Slack に投稿 → 待機期間 → ユーザーによる確認 → 連鎖的なクリーンアップdependency-management— 組織の依存関係承認ワークフローcost-investigation— 「ストレージ/データ転送料金が急増した理由は?」(具体的なバケットとクエリパターンを明記)
スキル作成のコツ
作成するスキルが決まったら、どのように記述すればよいのでしょうか?ここでは、Claude Codeチームが提案する、スキル作成に関するベストプラクティスやヒント、コツをいくつかご紹介します。
当たり前のことは言わないでください
Claude すでにプログラミングの知識があり、コードベースを読み解くことができる。Claudeがデフォルトで行う処理を単に再記述するだけのスキルは、文脈を追加するだけで付加価値を生み出さない。主に知識を提供することを目的としたスキルを公開する場合は、Claudeの通常の思考の枠組みを超えた情報に焦点を当てるべきだ。
フロントエンドのデザインスキルはその好例です。これは、Anthropicのエンジニアが、Claudeのデザインセンスを向上させるべく顧客と繰り返し協議を重ね、Interフォントや紫色のグラデーションといった定番のパターンを避けることで実現したものです。
「注意すべき点」のセクションを作成する
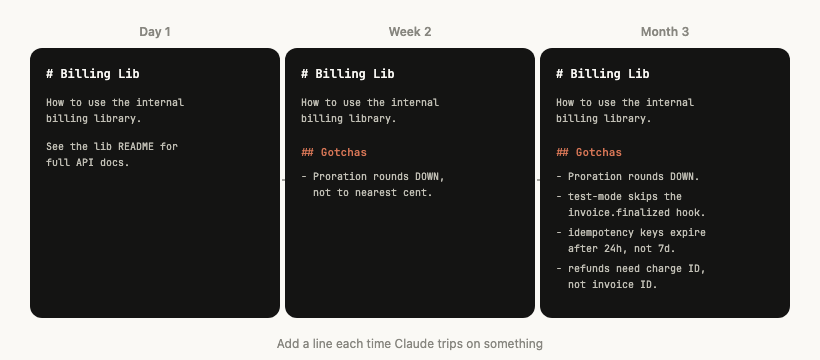
どのスキルにおいても、最も有益な情報は「注意点」セクションに含まれています。これらのセクションは、Claudeがスキルを操作する際に遭遇する一般的な失敗事例に基づいて作成されるべきです。理想的には、こうした注意点を反映させるために、時間をかけてスキルを更新していくことが望ましいでしょう。
例えば:
- 「この
subscriptionsこのテーブルは追記専用です。目的の行は、最新のものではなく、バージョン番号が最も高い行ですcreated_at." - 「このフィールドは
@request_idAPIゲートウェイではこう呼ばれ、trace_id課金サービスではこう呼ばれています。これらは同じ値です。」 - 「StripeのWebhookが実際には処理されていなくても、Stagingでは200が返されます。
payment_events実際の状態を確認してください。」
ファイルシステムと段階的な情報開示を活用する
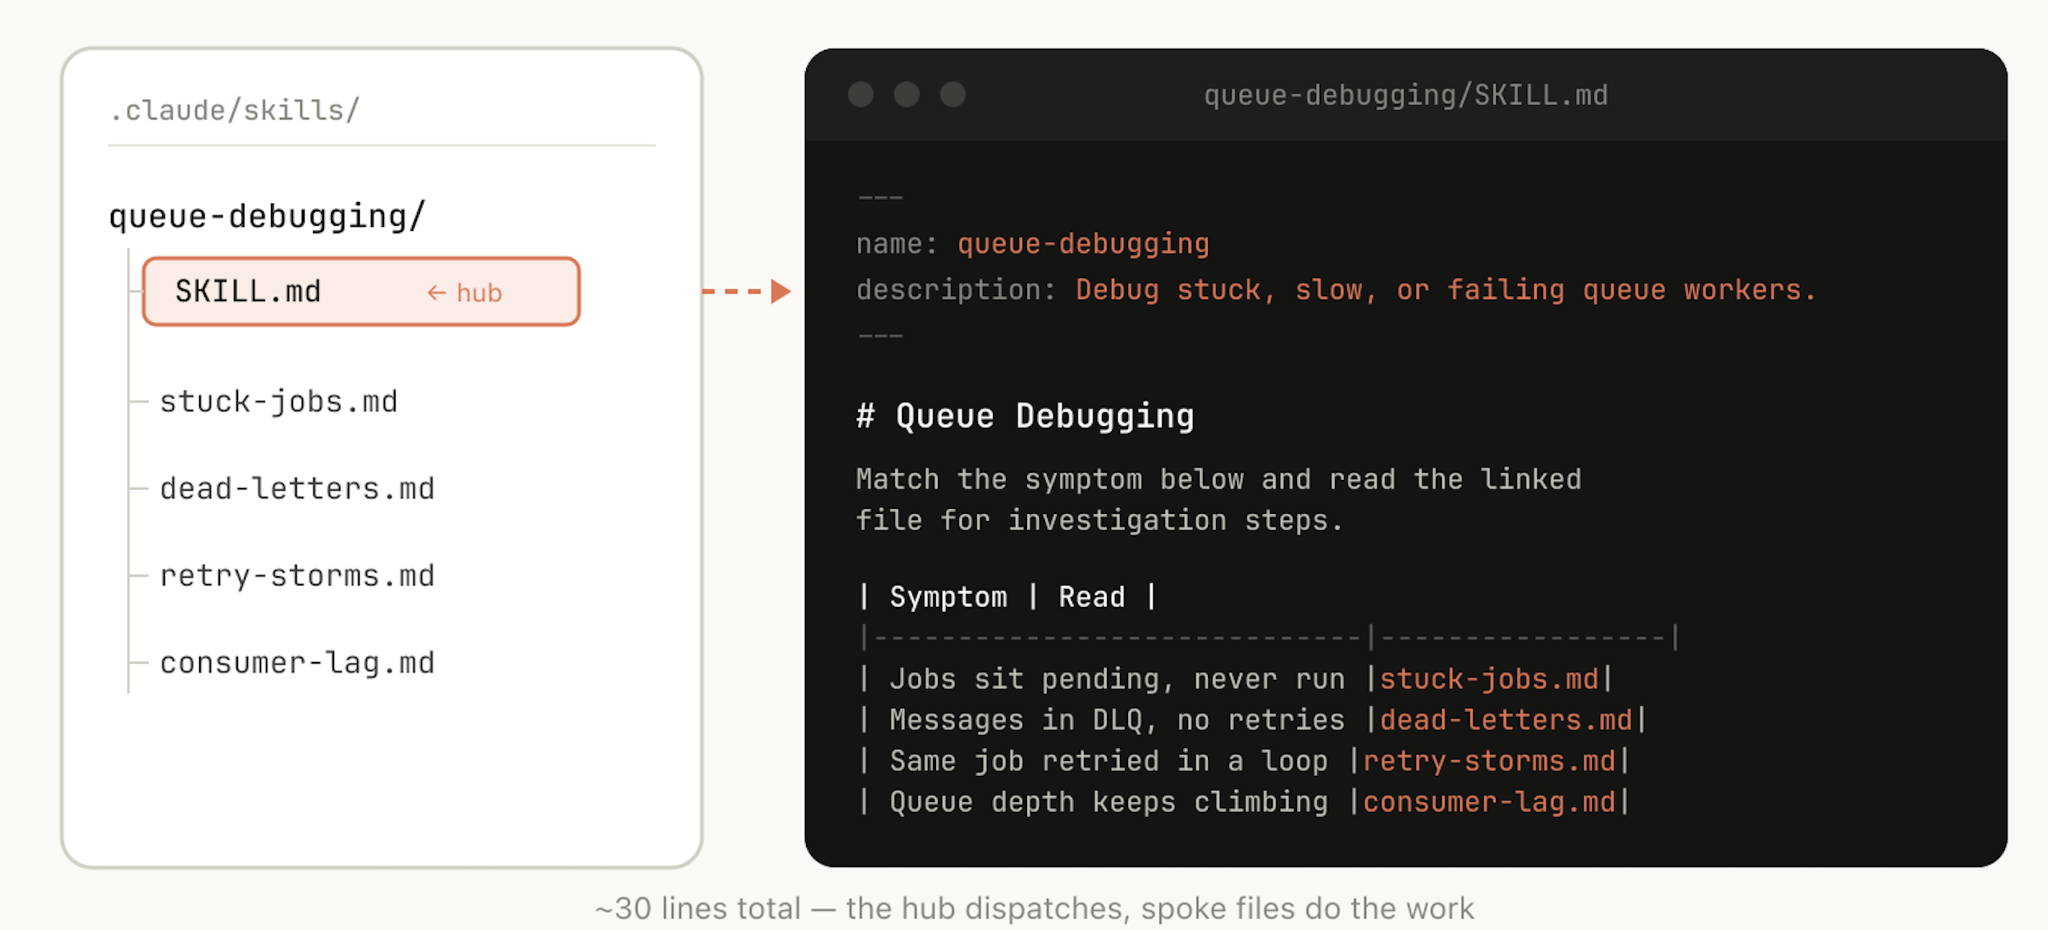
先ほども述べたように、スキルとは単なるMarkdownファイルではなく、フォルダそのものです。ファイルシステム全体を、コンテキストエンジニアリングおよび段階的な情報開示の一形態として捉えるべきです。Claudeに、スキルに含まれるファイルを指定すれば、適切なタイミングでそれらのファイルが読み込まれます。
段階的開示の最も単純な形は、Claude が参照する他のマークダウンファイルを指定することです。たとえば、詳細な関数のシグネチャや使用例を references/api.md.
もう1つの例:最終的な出力がMarkdownファイルである場合、そのテンプレートファイルを assets/ にそのテンプレートファイルを同梱し、コピーして使用できるようにします。
Claudeをより効果的に活用するために、リファレンス、スクリプト、サンプルなどをまとめたフォルダを作成することができます。
一方的な押し付けを避ける Claude
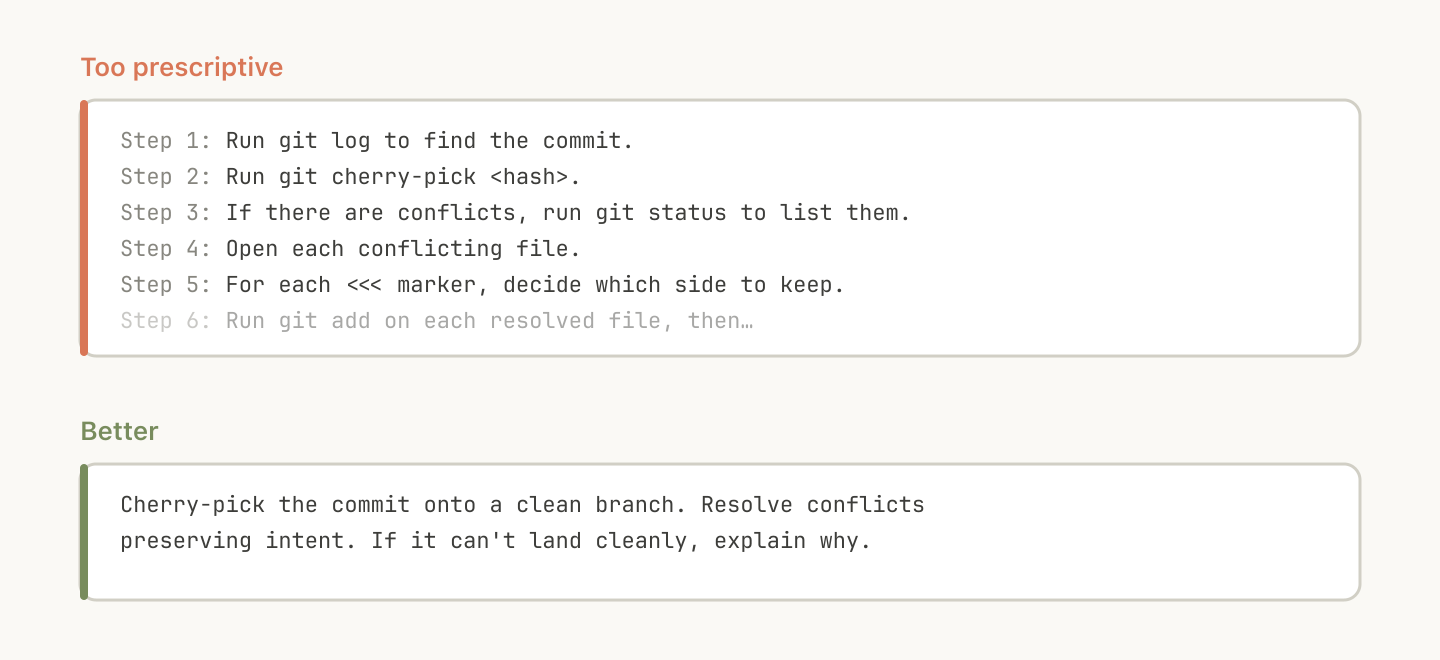
Claude Claudeは概して指示に従おうとします。また、スキルは非常に再利用性が高いため、指示をあまりに具体的にしすぎないよう注意が必要です。に必要な情報は提供しつつ、状況に応じて柔軟に対応できる余地を残しておきましょう。
例えば:
設定についてよく考えてみてください
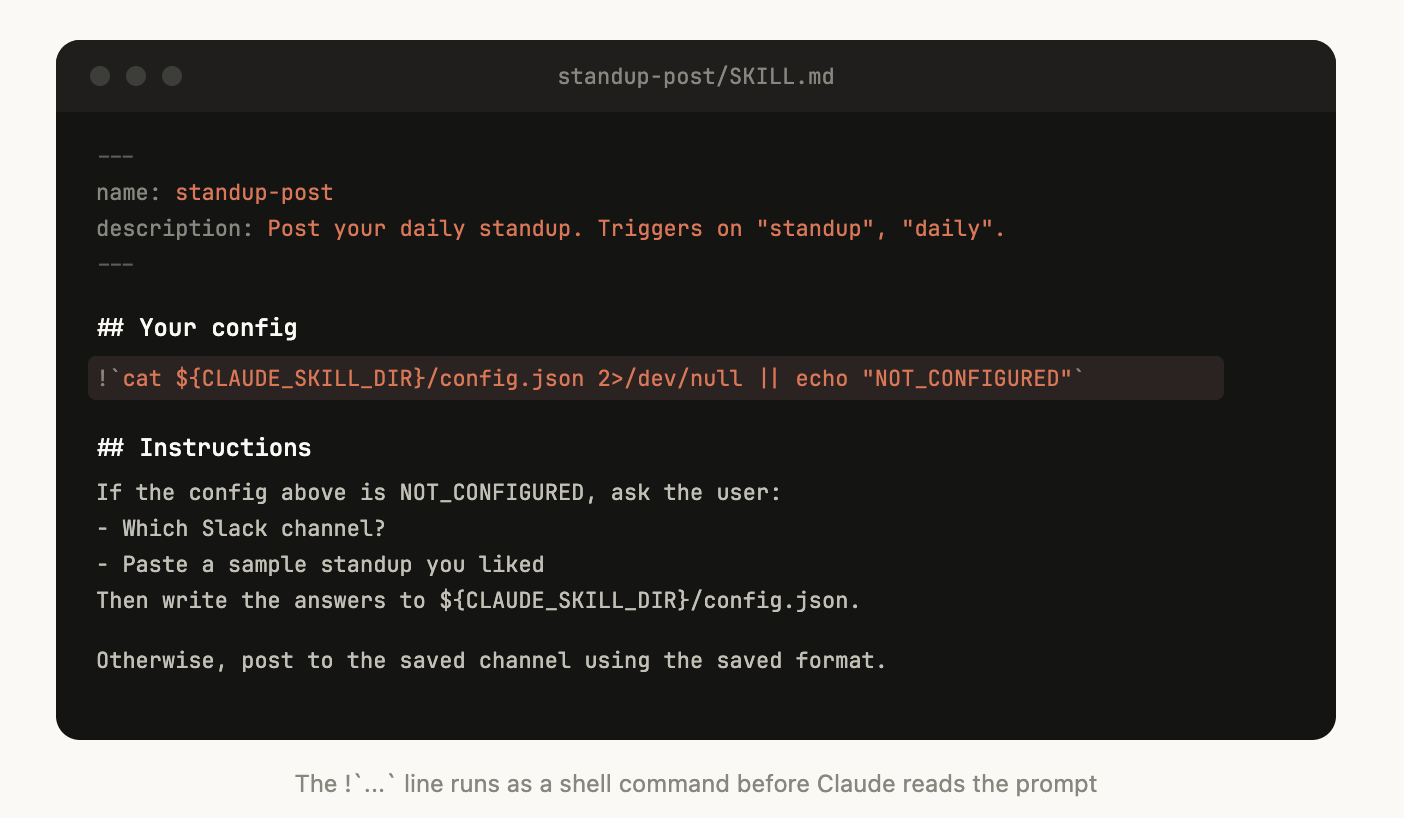
スキルによっては、ユーザーからのコンテキストに基づいて設定を行う必要がある場合があります。たとえば、スタンドアップの内容を Slack に投稿するスキルを作成する場合、Claude を使用して、どの Slack チャンネルに投稿するかを尋ねるように設定するとよいでしょう。
これを行うための良い方法は、上記の例のように、この設定情報をスキルディレクトリ内のconfig.jsonファイルに保存することです。設定が設定されていない場合、エージェントはユーザーに情報を尋ねることができます。
エージェントに構造化された多肢選択式の問題を出題させたい場合は、Claudeに「AskUserQuestion」ツールを使用するよう指示することができます。
人間向けではなく、モデル向けの説明文を書いてください
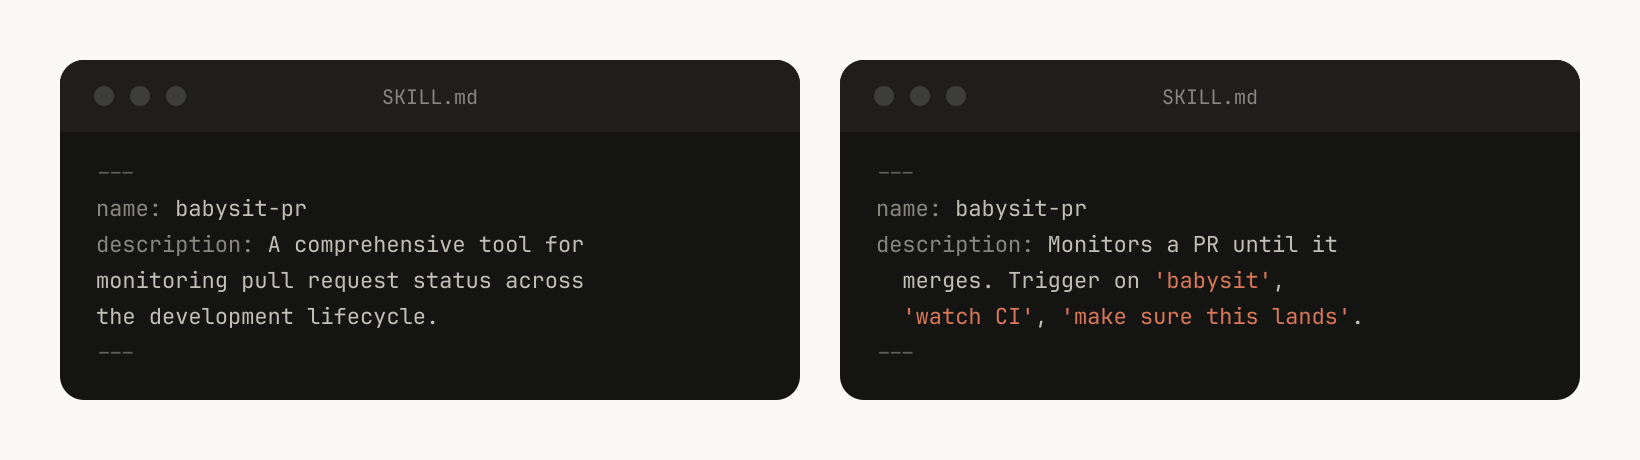
Claude Codeがセッションを開始すると、利用可能なすべてのスキルとその説明の一覧が作成されます。この一覧は、Claudeが「このリクエストに対応するスキルはあるか」を判断するためにスキャンするものです。つまり、説明フィールドは要約ではなく、このスキルをいつトリガーすべきかを説明するものです。
Claudeの思い出を語り継ごう
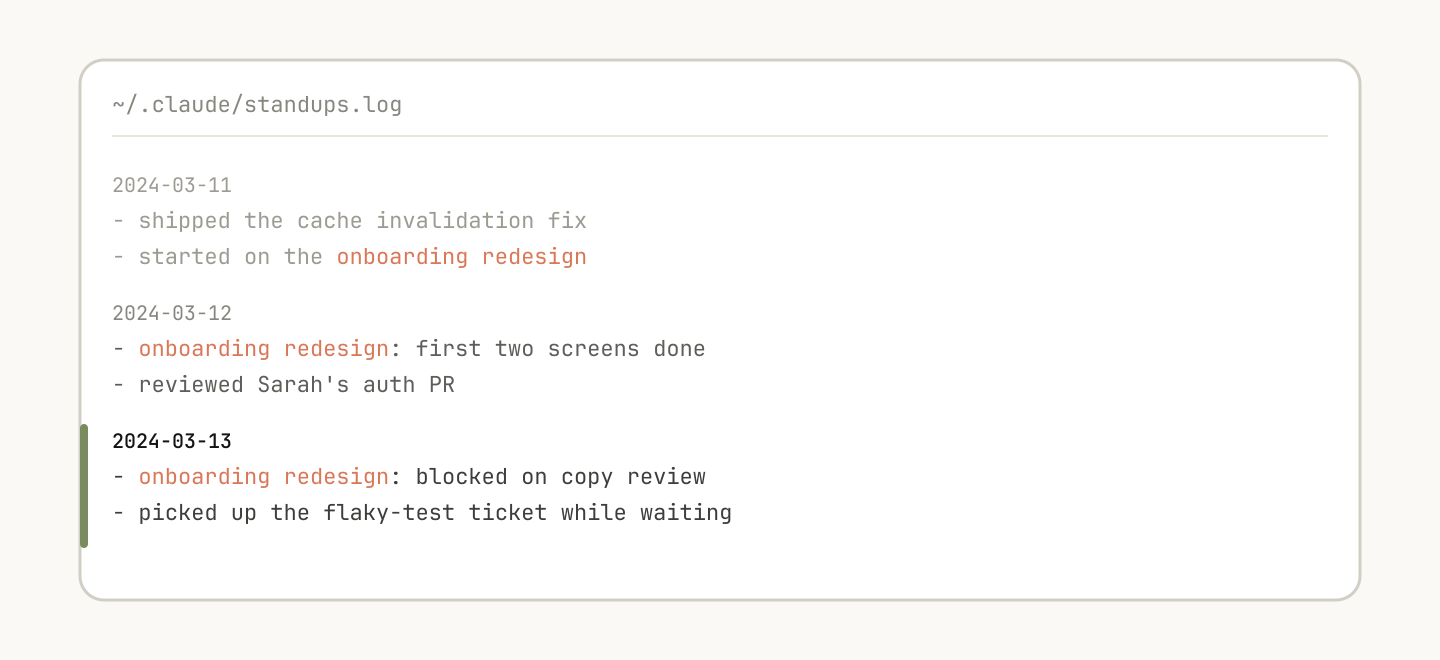
一部のスキルには、データを内部に保存することで、ある種の記憶機能を備えているものもあります。データの保存先としては、書き込み専用テキストログファイルやJSONファイルといった単純なものから、SQLiteデータベースのような複雑なものまで、あらゆるものが考えられます。
たとえば、ある standup-post スキルは、書き込んだすべての投稿を「standups.log」というファイルに記録しておくことがあります。つまり、次にそのスキルを実行した際、Claudeは自身の履歴を読み取り、昨日から何が変更されたかを把握できるのです。
環境変数 ${CLAUDE_PLUGIN_DATA} を使用して、データを保存できる安定したディレクトリを取得できます。スキルにおけるデータの永続化については、こちらをご覧ください:https://code.claude.com/docs/en/plugins-reference#persistent-data-directory。
スクリプトの保存とコードの生成
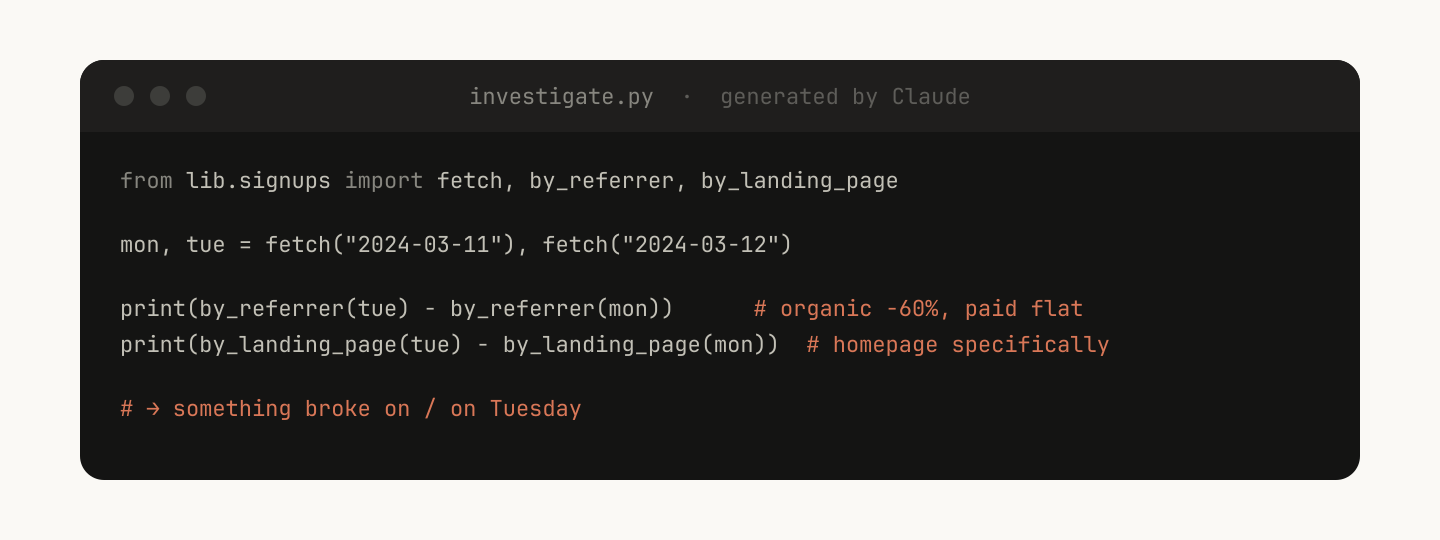
Claudeに提供できる最も強力なツールの一つがコードです。Claudeにスクリプトやライブラリを提供することで、Claudeは定型コードの再構築に時間を費やすことなく、次の行動を決定する「構成」にターンを費やすことができます。
たとえば、 data-science スキルには、イベントソースからデータを取得するための関数のライブラリが用意されているかもしれません。Claudeが複雑な分析を行えるようにするために、次のようなヘルパー関数のセットをに提供することができます:
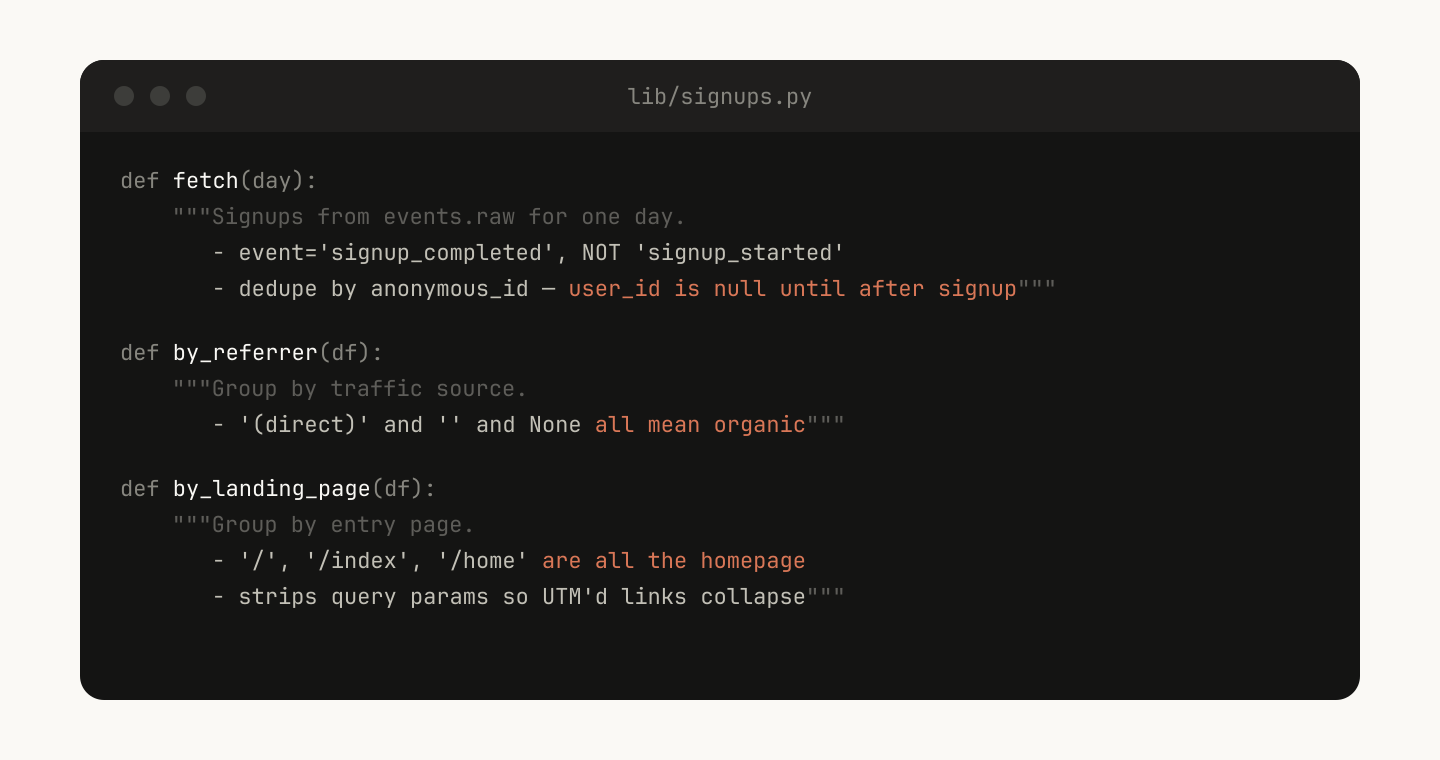
Claude これにより、その場でスクリプトを生成してこの機能を組み込み、「火曜日に何が起こったの?」といったプロンプトに対して、より高度な分析を行うことが可能になります。
オンデマンドフックの使用
スキルには、そのスキルが呼び出されたときにのみ発動し、セッションの期間中のみ有効なフックを含めることができます。これは、常に実行させる必要はないものの、時折非常に役立つような、特定の用途に特化したフックに活用してください。
例えば:
/careful— Bash上のPreToolUseマッチャーにより、rm -rf、DROP TABLE、force-push、kubectl deleteをブロックします。これは、本番環境にアクセスしていることが確実な場合にのみ有効にするべきです。常に有効にしておくと、気が狂いそうになります。/freeze— 特定のディレクトリ以外での編集・書き込みをすべてブロックします。デバッグ中に便利です。「ログを追加したいのに、うっかり関係のないコードを『修正』してしまってしまう」といった場合に役立ちます。
スキルの活用
スキルの最大のメリットの一つは、それをチームの他のメンバーと共有できることです。
他の人とスキルを共有するには、主に2つの方法があります:
- 自分のスキルをリポジトリにチェックインしてください(
./.claude/skills) - プラグインを作成し、ユーザーがプラグインをアップロード・インストールできる「Claude Code」プラグインマーケットプレイスを活用しましょう(詳細についてはこちらのドキュメントをご覧ください)。
リポジトリの数が比較的少ない小規模なチームの場合、スキルをリポジトリにチェックインする方法は有効です。しかし、チェックインされるスキル1つごとに、モデルのコンテキストが少しずつ増えます。規模が拡大するにつれて、内部のプラグインマーケットプレイスを活用することで、スキルを配布し、チームがどのスキルをインストールするかを決定できるようにするとともに、セットアップ手順を含めることも可能になります。
スキル・マーケットプレイスの運営
マーケットプレイスに掲載するスキルは、どのように決めているのですか?また、ユーザーはどのようにスキルを登録するのですか?
Anthropic では、決定を下す一元的なチームは存在しません。その代わりに、最も有用なスキルを自然な形で見つけ出そうとしています。もし誰かが、他の人に試してもらいたいスキルを持っている場合は、GitHub 内のサンドボックスフォルダにそれをアップロードし、Slack やその他のフォーラムでその存在を周知することができます。
スキルがある程度定着したら(その判断はスキル所有者に委ねられます)、マーケットプレイスに掲載するためのプルリクエストを送信することができます。
作文力
互いに依存し合うスキルを定義したい場合もあるでしょう。 たとえば、ファイルをアップロードする「ファイルアップロード」スキルと、CSVを作成してアップロードする「CSV生成」スキルがある場合です。このような依存関係の管理機能は、現時点ではマーケットプレイスやスキルに標準で組み込まれていませんが、他のスキルを名前で参照するだけで、それらがインストールされていればモデルが自動的に呼び出します。
測定スキル
スキルの運用状況を把握するために、社内のスキル使用状況をログに記録できる「PreToolUse」フックを使用しています(サンプルコードはこちら)。これにより、人気のあるスキルや、予想に比べて使用頻度が低いスキルを特定することができます。
はじめに
スキルのベストプラクティスは、今もなお進化し続けています。私たちのベストプラクティスの多くは、当初は数行のコードと1つの注意点から始まりましたが、Claudeが新たなエッジケースに直面するたびに、人々が改良を重ねた結果、より良いものになっていきました。
スキルを身につけるには、まず始めてみて、いろいろ試してみて、自分に合う方法を見つけるのが一番です。
この記事は、Anthropicの技術スタッフであり、Claude Codeのプロジェクトに携わっているThariq Shihipar氏によって執筆されました。